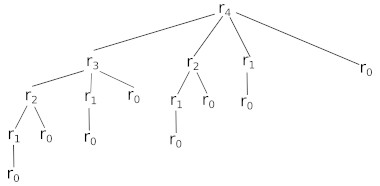
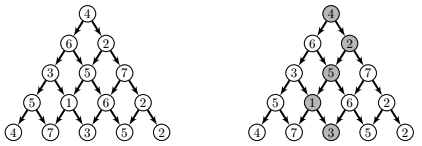
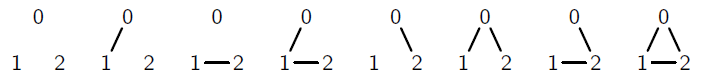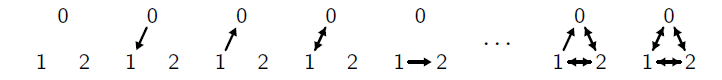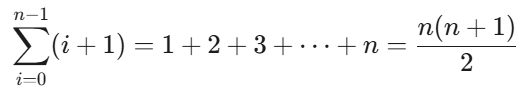Si vous êtes dans une situation de handicap et que vous bénéficiez d’aménagements pour le BAC merci de m’envoyer un message direct, que je puisse vérifier que votre dossier et à jour afin que vous bénéficiez bien des aménagements en juin et lors du bac blanc.
un tiers de la classe n’a pas rempli le questionnaire https://forms.gle/Q7G9yGQb8aBtLn9Y8 ou croit l’avoir fait mais a oublié de valider celui-ci après la saisie. Merci de corriger le tir.
Pour PIX, après discussion avec les référents PIX du lycée voici quelques précisions :
MERCI de bien vouloir vous connectez rapidement à votre compte pour vérifier que tout fonctionne bien.
Même si vous n’avez jamais utilisé PIX durant vos années lycée ou que vous n’avez pas de code de connexion, ça n’est pas grave en passant par l’ENT → Ressources → Médiacentre → PIX, il y a de fortes chances que ça passe quand même. Si vous testez et que ça ne fonctionne pas dites le moi que je puisse éventuellement vous réinitialiser vos identifiants depuis l’interface professeur de PIX Orga.
Concernant l’évaluation ponctuelle, les résultats de la certification PIX remontent dans Parcoursup. En revanche, si l’élève rate sa certification PIX, cela n’a aucune conséquence sur l’obtention du baccalauréat.
L’évaluation est individualisée : les questions proposées sont notamment adaptées au niveau atteint par l’élève lors des entraînements. Les élèves ne passent donc pas nécessairement tous exactement les mêmes questions. par contre ils ont tous 32 questions.
est ce que toutes les demandes d’aménagement ont été faite / validées
heure de vie de classe du 25/09/25
PIX
Nom campagne : Parcours de rentrée Tle Code : BHMHSJ686
Dates :
Cette année encore, les élèves de Terminale en LGT et LP, de CAP, ainsi que les étudiants en 2e année de BTS passeront la Certification Pix dans leur établissement :
– dans les lycées, Du 2 novembre 2026 au 5 mars 2027 avec une semaine de rattrapage du 8 au 12 mars 2027 pour les élèves empêchés
A – Procédures pour les élèves ou les étudiants :
1 – Ils doivent passer par l’ENT (Ressources -> Médiacentre -> PIX)
2 – Ils doivent se « synchroniser » avec l’ENT à la première connexion, il peut arriver que certains se soient déjà connectés avec un autre moyen il leur sera demandé identifiant et mot de passe de cet autre moyen (mail, identifiant).
3 – Une fois sur PIX, ils saisissent le code de la campagne de rentrée de leur niveau.
4 – Ils suivent le parcours puis ils doivent envoyer leurs résultats à la fin.
next : heure de vie de classe le 25/9/25 pour l’élection des délégués : vendredi 25 septembre 14h en A208.
La recherche d’un motif (une sous-chaîne) dans un texte est un problème fondamental en informatique. Que ce soit pour la fonction « Rechercher » de votre éditeur de texte ou pour l’analyse de séquences génomiques en bioinformatique, l’efficacité de ces algorithmes est cruciale.
1. Le problème de la recherche textuelle
L’objectif est de déterminer si une chaîne de caractères appelée motif est présente dans une chaîne plus longue appelée texte, et si oui, à quel(s) indice(s).
Exemple :
Texte :L'informatique est la science du traitement automatique.
Motif :mati
Résultat : Le motif est présent à l’indice 8. (Rappel : l’indice commence à 0 et les espaces comptent).
2. L’algorithme de recherche « Naïf »
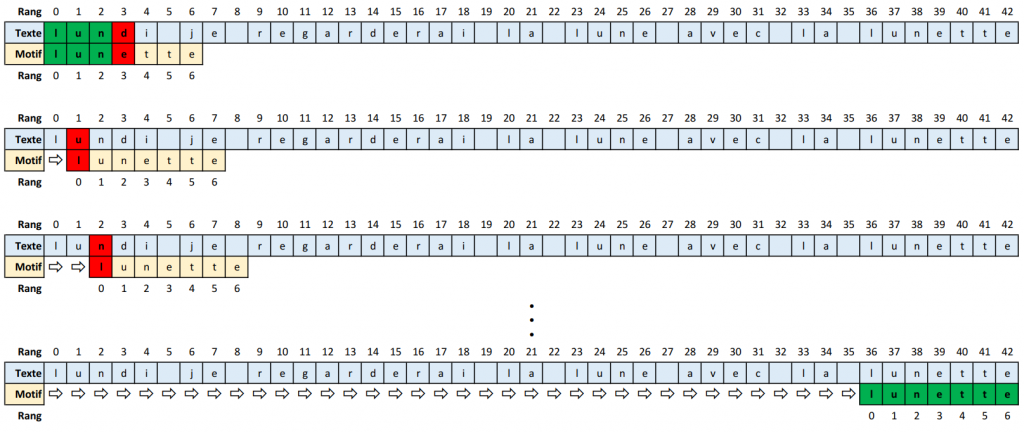
L’approche la plus simple consiste à faire glisser le motif devant le texte, caractère par caractère, et à vérifier la correspondance à chaque position.
Fonctionnement :
On aligne le début du motif avec le début du texte.
On compare les caractères un par un.
Dès qu’une différence apparaît, on décale le motif d’une seule position vers la droite et on recommence.
Limites :
Cet algorithme est peu efficace. Dans le pire des cas, si le texte et le motif sont très longs et répétitifs, le nombre de comparaisons devient colossal.
def occurrence(m, t, i):
    """indique s’il y a une occurrence de la chaîne m dans la chaîne t à la position i"""
    # contrôler la possibilité qu'avec un i donné il puisse avoir une occurrence. On renvoie faux si ça n'est pas possible.

    # en cas de faisabilité , on teste effectivement l'occurence et on renvoie vrai ou faux suivant ce que l'on obtient.


def recherche(m, t):
    """affiche toutes les occurrences de m dans t"""
    # on fait une boucle avec un range pas débile et en cas d'occurence on fera un affichage pour communisuqer le rang où ça se passe.
correction à la fin de la page.
3. L’algorithme de Boyer-Moore-Horspool
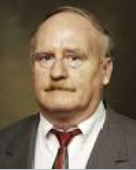
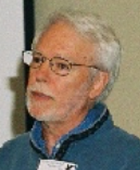
L’algorithme de Boyer et Moore est un algorithme de recherche textuelle très efficace developpé en 1977. Robert Stephen Boyer et J Strother Moore travaillaient alors à l’université d’Austin au Texas en tant qu’informaticiens.
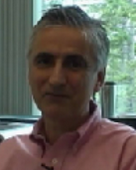
En 1980, Nigel Horspool a conçu une variante simplifiée de l’algorithme de Boyer-Moore. C’est cette version qu’on va étudier dans ce paragraphe.
Robert Stephen Boyer
J Stroter Moore
Nigel Horspool
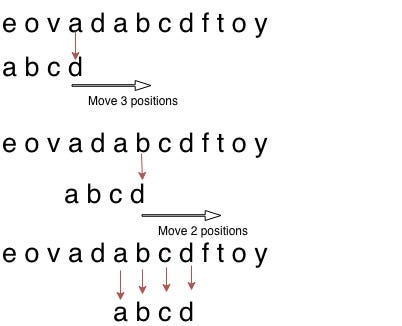
L’algorithme de Boyer-Moore (souvent étudié en NSI via sa version simplifiée, l’algorithme de Boyer-Moore-Horspool) améliore considérablement les performances grâce à deux idées géniales :
Sens de lecture : On compare les caractères du motif en partant de la droite (la fin du motif) vers la gauche.
Sauts stratégiques : Au lieu de décaler de 1, on effectue un prétraitement du motif pour savoir de combien de cases on peut « sauter » en cas d’erreur.
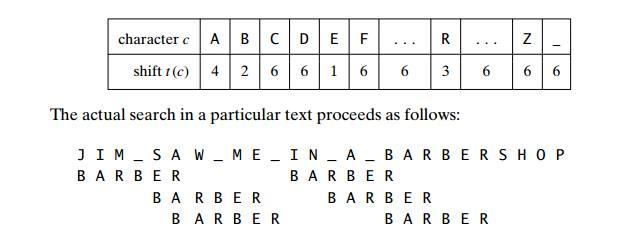
Exemple de fonctionnement :
Soit le texte ADN suivant : JIM SAW ME IN THE BARBERSHOP et le motif : BARBERSHOP.
Alignement initial : On compare la dernière lettre du motif (T) avec la lettre correspondante du texte.
Saut de caractère : Si la lettre du texte n’existe pas du tout dans le motif, on peut décaler le motif de toute sa longueur !
Alignement partiel : Si la lettre du texte existe dans le motif, on décale pour faire correspondre la dernière occurrence de cette lettre dans le motif.
4. Mise en pratique : Analyse d’ADN
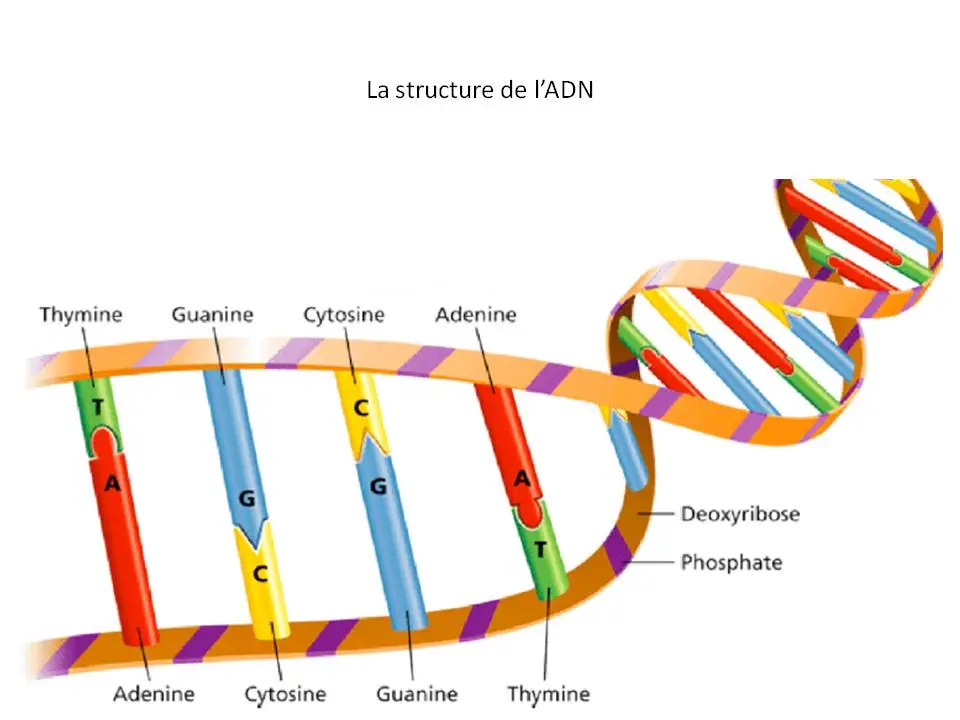
En bioinformatique, on cherche souvent des séquences spécifiques dans l’ADN (composé des bases A, T, G, C).
À faire vous-même 1
Appliquez manuellement l’algorithme de Boyer-Moore pour trouver le motif ACCTTCG dans la séquence suivante : CAATGTCTGCACCAAGACGCCGGCAGGTGCAGACCTTCGTTATAGGCGATGATTTCGAACCTACTAGTGGGTCTCTTAGGCCGAG
À faire vous-même 2 : Implémentation Python
Voici une implémentation de l’algorithme utilisant la table des sauts (prétraitement du motif). Complétez le code en utilisant les indications :
NO_CAR = 256 # Taille du jeu de caractères ASCII

def recherche_boyer_moore(txt, motif):
    m = len(motif)
    n = len(txt)

    # Prétraitement : on stocke la dernière position de chaque caractère du motif
    # on crée une table de décallage : une liste tab_car qui à chaque caractère repéré par code ascii (avec la fonction ord()) on va associer un décalage


    decalage = 0 # correspond à l'indice du placement de la première lettre du motif dans le texte
    res = [] # indique où trouver les différentes occurence du motif dans le texte

    while(decalage <= ?????):
        j = ????? # On commence par la fin du motif, j est l'indice de la lettre
        # du motif en cours de contrôle elle variera entre m-1 et 0

        # On remonte vers la gauche tant que les caractères correspondent
        # tant qu'avec j on est encore dans le mot et qu'il y a correspondance
        #entre texte et motif on recule d'un
        while j >= 0 and motif[j] == ?????:
            j = j - 1
        #si il y n'y a pas de problème et que toutes les lettres sont validées
        if j < 0:
            # Motif trouvé ! on rajoute une valeur pertinente dans la liste res
            res.append(decalage)
            # Décalage pour trouver l'occurrence suivante
            decalage += 1 #puis on décale d'une unité
        else:
            # Erreur de correspondance : on utilise la table de sauts
            # On commence par repèrer la lettre fautive dans le texte
            # et on cherche le décalage correspondant dans la table de sauts
            # et on décale
            ?????
    return res

# Test
mon_texte = "CAAGCGCACAAGACGCGGCAGACCTTCGTTATAGGCGCAAGCGCACAAGACGCGGCAGACCTTCGTTATAGGCGACCTTCG"
mon_motif = "ACCTTCG"
print(f"Motif trouvé aux indices : {recherche_boyer_moore(mon_texte, mon_motif)}")
À faire vous-même 3
Copiez le code ci-dessus dans votre IDE (Spyder, VS Code ou EduPython).
Testez-le avec la séquence ADN complète fournie dans l’exercice 1.
Comparez le temps d’exécution (théorique) avec l’algorithme naïf sur de très gros fichiers (comme un chromosome complet).
à retenir : L’algorithme naïf compare de gauche à droite et décale de 1. Complexité O(n×m).
4. L’algorithme de Boyer-Moore (Bonus)
L’algorithme Boyer-Moore compare de droite à gauche et utilise un prétraitement pour effectuer des sauts. Il est beaucoup plus efficace sur des alphabets larges et de longs motifs.
super exemple d’utilisation de l’algorithme avec beaucoup d’explication au deuxième tiers de la page suivante.
def table_bm(m):
    """construit la table de décalages de Boyer-Moore :
       d[j][c] est le plus grand k < j tel que m[k] == c,
       s’il existe, et n’est pas défini sinon"""
    d = [{} for _ in range(len(m))]
    for j in range(len(m)):
        for k in range(j):
            d[j][m[k]] = k
    return d

def decalage(d, j, c):
    """utilise la table d lorsque le caractère j est c
       au lieu du caractère attendu"""
    if c in d[j]:
        # c apparaît en d[j][c] et on décale de la différence
        return j - d[j][c]
    else:
        # c n’apparaît pas du tout dans m[0..j-1]
        return j + 1

def recherche(m, t):
    """affiche toutes les occurrences de m dans t
       avec l’algorithme de Boyer-Moore"""
    d = table_bm(m)
    i = 0
    while i <= len(t) - len(m):
        k = 0
        for j in range(len(m) - 1, -1, -1):
            if t[i + j] != m[j]:
                k = decalage(d, j, t[i + j])
                break
        if k == 0:
            print("occurrence à la position", i)
            k = 1
        i += k
Exercices d’application
Exercice 1 : Analyse de l’algorithme Naïf
En utilisant l’algorithme naïf, déterminez le nombre de comparaisons de caractères effectuées lors de la recherche du motif "chercher" dans le texte "chercher, rechercher et chercher encore". Note : On compte chaque comparaison, même celles qui échouent dès le premier caractère.
Exercice 2 : Première occurrence
En vous inspirant du fonctionnement de l’algorithme naïf, écrivez en Python une fonction premiere_occurrence(m, t) qui renvoie l’indice de la première occurrence du motif m dans le texte t. La fonction devra renvoyer None si le motif n’est pas présent.
Exercice 3 : Table de décalages (Boyer-Moore)
Construisez manuellement la table de décalages utilisée par l’algorithme de Boyer-Moore pour le motif suivant : "banane". Rappel : Pour chaque position j du motif, on cherche la position de la dernière occurrence du caractère lu dans le texte au sein de la partie gauche du motif.
Exercice 4 : Table de décalages avancée
Construisez manuellement la table de décalages de l’algorithme de Boyer-Moore pour le motif "chercher".
Exercice 5 : Déroulé complet et comparaison
En utilisant la table de décalages obtenue à l’exercice précédent, déroulez manuellement l’exécution de l’algorithme de Boyer-Moore pour la recherche du motif "chercher" dans le texte "chercher, rechercher et chercher encore".
Listez les valeurs successives de la variable d’indice i.
Indiquez le nombre total de comparaisons effectuées.
Comparez ce résultat avec celui de l’exercice 1. Quel algorithme est le plus efficace ici ?
Corrections des exercices
Correction Exercice 1
Le motif "chercher" fait 8 caractères. Le texte fait 38 caractères.
À la position 0 : 8 comparaisons (succès).
À la position 1 (l’espace) : 1 comparaison (échec).
À la position 10 (début de « rechercher ») : 1 comparaison (‘r’ vs ‘c’).
À la position 12 (le ‘c’ de « rechercher ») : 8 comparaisons (succès).
En suivant ce processus, on compte toutes les tentatives de décalage de 1 en 1. Total : 54 comparaisons.
Correction Exercice 2
def premiere_occurrence(m, t):
    n = len(t)
    len_m = len(m)
    for i in range(n - len_m + 1):
        match = True
        for j in range(len_m):
            if t[i + j] != m[j]:
                match = False
                break
        if match:
            return i
    return None
Correction Exercice 3 (Motif « banane »)
On liste pour chaque index j le dictionnaire des caractères rencontrés précédemment :
j=0 : {}
j=1 (‘a’) : {'b': 0}
j=2 (‘n’) : {'b': 0, 'a': 1}
j=3 (‘a’) : {'b': 0, 'a': 1, 'n': 2}
j=4 (‘n’) : {'b': 0, 'a': 3, 'n': 2} (le ‘a’ en 3 écrase le ‘a’ en 1)
j=5 (‘e’) : {'b': 0, 'a': 3, 'n': 4}
Correction Exercice 4 (Motif « chercher »)
j=0 : {}
j=1 (‘h’) : {'c': 0}
j=2 (‘e’) : {'c': 0, 'h': 1}
j=3 (‘r’) : {'c': 0, 'h': 1, 'e': 2}
j=4 (‘c’) : {'c': 0, 'h': 1, 'e': 2, 'r': 3}
j=5 (‘h’) : {'c': 4, 'h': 1, 'e': 2, 'r': 3}
j=6 (‘e’) : {'c': 4, 'h': 5, 'e': 2, 'r': 3}
j=7 (‘r’) : {'c': 4, 'h': 5, 'e': 6, 'r': 3}
Correction Exercice 5
Valeurs de i :
i=0 (Trouvé, on décale de 1 par défaut).
i=1 (Espace ‘ ‘, pas dans le motif : décalage j+1, ici 7+1=8).
i=9 (‘r’ vs ‘r’ OK, ‘e’ vs ‘e’ OK… jusqu’au ‘c’ de « rechercher »).
i=12 (Trouvé).
… et ainsi de suite.
Nombre de comparaisons : Environ 22 comparaisons.
Comparaison : Boyer-Moore est environ 2,5 fois plus efficace que l’algorithme naïf (54 vs 22 comparaisons) sur cet exemple grâce aux sauts de plusieurs caractères.
implémentations des algorithmes à connaitre :
version naïve
def occurrence(m, t, i):
    """indique s’il y a une occurrence de la chaîne m dans la chaîne t à la position i"""
    if i < 0 or i > len(t) - len(m):
        return False
    for j in range(len(m)):
        if t[i + j] != m[j]:
            return False
    return True

def recherche(m, t):
    """affiche toutes les occurrences de m dans t"""
    for i in range(0, len(t) - len(m) + 1):
        if occurrence(m, t, i):
            print("occurrence à la position", i)
bayer-Moor-Horspool (version extérieure, avec une table de décalage un peu différente)
NO_CAR = 256 # Taille du jeu de caractères ASCII

def recherche_boyer_moore(txt, motif):
    m = len(motif)
    n = len(txt)

    # Prétraitement : on stocke la dernière position de chaque caractère du motif
    tab_car = [-1] * NO_CAR
    for i in range(m):
        tab_car[ord(motif[i])] = i

    decalage = 0
    res = []

    while(decalage <= n - m):
        j = m - 1 # On commence par la fin du motif

        # On remonte vers la gauche tant que les caractères correspondent
        while j >= 0 and motif[j] == txt[decalage + j]:
            j = j - 1

        if j < 0:
            # Motif trouvé !
            res.append(decalage)
            # Décalage pour trouver l'occurrence suivante
            if decalage + m < n:
                decalage += m - tab_car[ord(txt[decalage + m])]
            else:
                decalage += 1
        else:
            # Erreur de correspondance : on utilise la table de sauts
            # On décale au maximum entre 1 et la règle du mauvais caractère
            decalage += max(1, j - tab_car[ord(txt[decalage + j])])

    return res

# Test
mon_texte = "CAAGCGCACAAGACGCGGCAGACCTTCGTTATAGGCG"
mon_motif = "ACCTTCG"
print(f"Motif trouvé aux indices : {recherche_boyer_moore(mon_texte, mon_motif)}")
Horspool Version Kergot
NO_CAR = 256 # Taille du jeu de caractères ASCII

def recherche_boyer_moore(txt, motif):
    m = len(motif)
    n = len(txt)

    # Prétraitement : on stocke la dernière position de chaque caractère du motif
    # on crée une table de décallage : une liste tab_car qui à chaque caractère repéré par code ascii (avec la fonction ord()) on va associer un décalage
    tab_car = [m] * NO_CAR
    for i in range(m-1):
        tab_car[ord(motif[i])] = m-1-i

    decalage = 0 # correspond à l'indice du placement de la première lettre du motif dans le texte
    res = [] # indique où trouver les différentes occurence du motif dans le texte

    while(decalage <= n - m):
        j = m - 1 # On commence par la fin du motif, j est l'indice de la lettre
        # du motif en cours de contrôle elle variera entre m-1 et 0

        # On remonte vers la gauche tant que les caractères correspondent
        # tant qu'avec j on est encore dans le mot et qu'il y a correspondance
        #entre texte et motif on recule d'un
        while j >= 0 and motif[j] == txt[decalage + j]:
            j = j - 1
        #si il y n'y a pas de problème et que toutes les lettres sont validées
        if j < 0:
            # Motif trouvé ! on rajoute une valeur pertinente dans la liste res
            res.append(decalage)
            # Décalage pour trouver l'occurrence suivante
            decalage += 1 #puis on décale d'une unité
        else:
            # Erreur de correspondance : on utilise la table de sauts
            # On commence par repèrer la lettre fautive dans le texte
            # et on cherche le décalage correspondant dans la table de sauts
            # et on décale

            decalage += tab_car[ord(txt[decalage + j])]

    return res

# Test
mon_texte = "CAAGCGCACAAGACGCGGCAGACCTTCGTTATAGGCGCAAGCGCACAAGACGCGGCAGACCTTCGTTATAGGCGACCTTCG"
mon_motif = "ACCTTCG"
print(f"Motif trouvé aux indices : {recherche_boyer_moore(mon_texte, mon_motif)}")
Comme pour les arbres, il existe différentes façons de parcourir un graphe. On peut le parcourir en largeur ou en profondeur. Le parcours d’un graphe consiste à visiter tous ses nœuds.
Parcours en largeur
Nous allons utiliser des nœuds avec un attribut « visite » à « Faux » par défaut et qui sera mis à « Vrai » lorsqu’il aura été visité. Des nœuds sont dit adjacents ou voisins s’ils sont réliés par une arrête. Voici donc un algorithme du parcours en largeur :
VARIABLES
f : file
nœud : nœud de départ (origine)
x : nœud actuellement visité
y : nœud

DEBUT
nœud.visite = Vrai
f.enfile(nœud)
tant que f est non vide:
    x = f.defile()
    afficher x
    pour chaque y adjacent à x:
        si y.visite est Faux:
            y.visite = Vrai
            f.enfile(y)
FIN
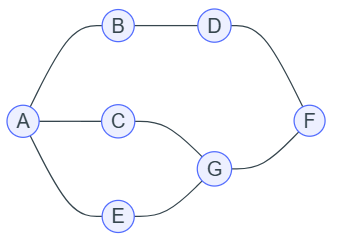
1) Appliquez cet algorithme au graphe ci-dessous en partant de A. On notera sur une même ligne le nœud actuellement visité et le contenu de la file f. Dans le cas de plusieurs voisins, on les ajoutera dans l’ordre alphabétique.
2) Faire un tableau des distances entre A et les autres nœuds.
3) Qui a-t-il de remarquable entre ce tableau et le parcours en largeur ?
4) Appliquez à nouveau cet algorithme au graphe ci-dessous en prenant A comme nœud initial.
Parcours en profondeur
Voici maintenant un algorithme qui propose un parcours en profondeur :
VARIABLES
nœud : nœud de départ (origine)

DEBUT
profondeur(nœud):
    nœud.visite = True
    afficher nœud
    pour chaque y adjacent à nœud:
        si y.visite est Faux:
            profondeur(y)

FIN
5) Quelle est la particularité de ce programme par rapport au parcours en largeur ?
6) Appliquez cet algorithme au graphe ci-dessous en partant de A.
7) Appliquez à nouveau cet algorithme au graphe ci-dessous en prenant A comme nœud initial.
Chemin
Il est souvent nécessaire de trouver un chemin entre deux nœuds d’un graphe. Voici un algorithme qui permet de faire cette recherche :
VARIABLES
graphe : le graphe
start : nœud de départ (origine)
end : nœud d'arrivée
chaine : chemin initialement vide

DEBUT
trouve-chaine(graphe, start, end, chaine)
    ajouter start à chaine
    si start = end:
        retourner chaine
    pour chaque y adjacent à start:
        si y n'appartient pas à chaine:
            chemin = trouve-chaine(graphe, y, end, chaine)
            si chemin est non-vide
                retourner chemin
    retourner None
FIN
8) Appliquez rigoureusement cet algorithme au graphe ci-dessous entre A et C.
9) Appliquez à nouveau cet algorithme au graphe ci-dessous entre A et C.
Cycle
Un cycle est une suite d’arrêtes (donc une chaine) dont les deux extrémités sont identiques.
Il est parfois intéressant de savoir si un graphe contient un cycle. Par exemple un graphe qui contient un cycle ne peut pas être un arbre.
Voici donc un algorithme qui permet de détecter s’il y a au moins un cycle dans un graphe :
VARIABLES
graphe : le graphe
d : le nœud de départ
p : pile

DEBUT
trouve-cycle(graphe, d)
    p.empile(d)
    tant que p n'est pas vide:
        x = p.depile()
        pour chaque y adjacent à x:
            si y.visite est Faux:
                p.empile(y)
        si x.visite est Vrai:
            retourner Vrai
        sinon:
            x.visite = Vrai
    retourner Faux
FIN
10) Appliquez cet algorithme au graphe en haut de page en prenant A comme nœud initial.
11) Appliquez à nouveau cet algorithme au graphe ci-dessous en prenant A comme nœud initial.
implémentations : programmes de référence
Programme 1 —Parcours en profondeur
def parcours(g, vus, s):
     """parcours en profondeur depuis le sommet s"""
     if s not in vus:
          vus.add(s)
          for v in g.voisins(s):
               parcours(g, vus, v)

def existe_chemin(g, u, v):
     """existe-t-il un chemin de u à v ?"""
     vus = set()
     parcours(g, vus, u)
     return v in vus
Programme 2 — Parcours en profondeur avec une pile
def parcours(g, vus, s):
     """parcours en profondeur depuis le sommet s"""
     pile = Pile()
     pile.empiler(s)
     while not pile.est_vide():
          s = pile.depiler()
          if s in vus:
               continue
          vus.add(s)
          for v in g.voisins(s):
               pile.empiler(v)
Programme 3 — Détecter la présence d’un cycle dans un graphe
BLANC, GRIS, NOIR = 1, 2, 3
def parcours_cy(g, couleur, s):
     """parcours en profondeur depuis le sommet s"""
     if couleur[s] == GRIS:
          return True
     if couleur[s] == NOIR:
          return False
     couleur[s] = GRIS
     for v in g.voisins(s):
          if parcours_cy(g, couleur, v):
               return True
     couleur[s] = NOIR
     return False

def cycle(g):
     couleur = {}
     for s in g.sommets():
          couleur[s] = BLANC
     for s in g.sommets():
          if parcours_cy(g, couleur, s):
               return True
     return False
Programme 4 — Parcours en largeur
def parcours_largeur(g, source):
     """parcours en largeur depuis le sommet source"""
     dist = {source: 0}
     courant = {source}
     suivant = set()
     while len(courant) > 0:
          s = courant.pop()
          for v in g.voisins(s):
               if v not in dist:
                    suivant.add(v)
                    dist[v] = dist[s] + 1
          if len(courant) == 0:
               courant, suivant = suivant, set()
     return dist

def distance(g, u, v):
     """distance de u à v (et None si pas de chemin)"""
     dist = parcours_largeur(g, u)
     return dist[v] if v in dist else None
Exercices
Exercice 1
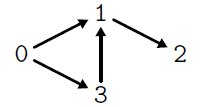
Dérouler à la main le parcours en profondeur sur le graphe suivant
pour différentes valeurs du sommet de départ. Donner à chaque fois la valeur finale de l’ensemble vus, c’est-à-dire l’ensemble des sommets atteints par le parcours.
Exercice 2
Dérouler à la main le parcours en largeur sur le graphe suivant
pour différentes valeurs du sommet de départ. Donner à chaque fois la valeur finale du dictionnaire dist, c’est-à-dire la distance à la source de chaque sommet atteint par le parcours.
Exercice 3
On peut se servir d’un parcours en profondeur pour déterminer si un graphe non orienté est connexe, c’est-à-dire si tous ses sommets sont reliés entre eux par des chemins. Pour cela, il suffit de faire un parcours en profondeur à partir d’un sommet quelconque, puis de vérifier que tous les sommets ont été atteints par ce parcours. Écrire une fonction est_connexe() qui réalise cet algorithme. On pourra se servir de la méthode sommets() de la classe Graphe et de la fonction parcours du programme de référence 1 voir plus haut .
Exercice 4
Dans cet exercice, on se propose d’utiliser le parcours en profondeur pour construire un chemin entre deux sommets, lorsque c’est possible. On le fait avec deux fonctions, comme dans le programme de référence 1 voir plus haut.
def parcours_ch(g, vus, org, s):
    """parcours depuis le sommet s, en venant de org"""
    …
def chemin(g, u, v):
    """un chemin de u à v, le cas échéant, None sinon"""
    …
L’idée est que l’attribut vus n’est plus un ensemble mais un dictionnaire, qui associe à chaque sommet visité le sommet qui a permis de l’atteindre pendant le parcours en profondeur. La fonction parcours_ch prend un argument supplémentaire, org (pour origine), qui est justement le sommet qui a permis d’atteindre s, en empruntant l’arc org → s. Écrire le code de la fonction parcours_ch ; il est très semblable à celui de la fonction parcours du programme de référence n°1 . Écrire ensuite le code de la fonction chemin qui renvoie un chemin entre les sommets u et v, le cas échéant, et None s’il n’existe pas de chemin entre ces deux sommets. Pour cela, lancer un parcours en profondeur à partir du sommet u, en donnant à org la valeur None, puis, si le sommet v a été atteint, construire le chemin dans un tableau en« remontant » le dictionnaire vus de v jusqu’à u.
Exercice 5
Dans cet exercice, on se propose d’utiliser le parcours en largeur pour construire un chemin de longueur minimale entre deux sommets. On le fait avec deux fonctions, comme dans le programme de référence n°4.
def parcours_largeur_ch(g, source):
    """parcours depuis le sommet source"""
    …

def chemin(g, u, v):
    """un chemin de u à v, le cas échéant, None sinon"""
    …
L’idée est qu’un dictionnaire vus remplace le dictionnaire dist. Ce dictionnaire vus associe à chaque sommet visité le sommet qui a permis de l’atteindre pendant le parcours en largeur. Écrire le code de la fonction parcours_largeur_ch ; il est très semblable à celui de la fonction parcours_largeur du programme de référence 4. Pour le sommet source, on lui associe la valeur None dans le dictionnaire vus. Écrire ensuite le code de la fonction chemin qui renvoie un chemin réalisant la distance entre les sommets u et v, le cas échéant, et None s’il n’existe pas de chemin entre ces deux sommets. Pour cela, lancer un parcours en largeur à partir du sommet u puis, si le sommet v a été atteint, construire le chemin dans un tableau en« remontant » le dictionnaire vus de v jusqu’à u.
Exercice 6
Les nœuds d’un arbre binaire peuvent être vus comme les sommets d’un graphe non orienté. En particulier, on peut donc parcourir les nœuds d’un arbre avec un parcours en profondeur ou en largeur. Pour le parcours en profondeur, il s’agit d’un parcours que nous avons déjà présenté, à savoir le parcours préfixe . Dans cet exercice, on se propose de parcourir les nœuds d’un arbre binaire avec un parcours en largeur. Écrire une fonction largeur(a) qui reçoit un arbre binaire a en argument et imprime les valeurs de ses différents nœuds dans un ordre donné par un parcours en largeur, c’est-à-dire la valeur contenue dans la racine, puis les valeurs contenues dans les nœuds immédiatement en-dessous (profondeur 1), puis celles contenues dans les nœuds encore en-dessous (profondeur 2), etc. Adapter pour cela le code du programme de référence 4.
Corrections
Exercice 1
sommet de départ
valeur finale de vus
0
{0, 1, 3, 2}
1
{1, 2}
2
{2}
3
{3, 1, 2}
Exercice 2
sommet de départ
valeur finale de dist
0
{0 → 0, 1 → 1, 3 → 1, 2 → 2}
1
{1 → 0, 2 → 1}
2
{2 → 0}
3
{3 → 0, 1 → 1, 2 → 2}
Exercice 3
On suit l’algorithme proposé, en faisant uniquement attention au cas pathologique d’un graphe qui ne contiendrait aucun sommet.
def est_connexe(g):
    """le graphe est-il connexe ?
    (uniquement pour un graphe non orienté)"""
    ts = g.sommets()
    if len(ts) == 0:
        return True
    s = ts.pop()
    vus = set()
    parcours(g, vus, s)
    for s in ts:
        if s not in vus:
            return False
    return True
Exercice 4
Pour parcours_ch, l’ajout dans un ensemble devient un ajout dans un dictionnaire.
def parcours_ch(g, vus, org, s):
    """parcours depuis le sommet s, en venant de org"""
    if s not in vus:
        vus[s] = org
        for v in g.voisins(s):
            parcours_ch(g, vus, s, v)
Pour chemin, on prend soin de tester si v a été atteint par le parcours. Dans le cas contraire, on renvoie None. Sinon, on construit le chemin avec une boucle while.
def chemin(g, u, v):
    """un chemin de u à v, le cas échéant, None sinon"""
    vus = {}
    parcours_ch(g, vus, None, u)
    if v not in vus:
        return None
    ch = []
    s = v
    while s is not None:
        ch.append(s)
        s = vus[s]
    ch.reverse()
    return ch
De fait, le chemin est construit à l’envers. On prend soin de le renverser avec la méthode reverse avant de le renvoyer.
Exercice 5
On garde la structure du programme 4, le dictionnaire vus prenant la place du dictionnaire dist.
def parcours_largeur_ch(g, source):
    """parcours depuis le sommet source"""
    vus = {source: None}
    courant = {source}
    suivant = set()
    while len(courant) > 0:
        s = courant.pop()
        for v in g.voisins(s):
            if v not in vus:
                suivant.add(v)
                vus[v] = s
        if len(courant) == 0:
            courant, suivant = suivant, set()
    return vus
La seconde partie, à savoir la reconstruction du chemin, n’est pas différente de celle effectuée dans l’exercice précédent pour un parcours en profondeur.
def chemin(g, u, v):
    """un chemin de u à v, le cas échéant, None sinon"""
    vus = parcours_largeur_ch(g, u)
    if v not in vus:
        return None
    ch = []
    s = v
    while s is not None:
        ch.append(s)
        s = vus[s]
    ch.reverse()
    return ch
Exercice 6
La subtilité consiste ici à correctement traiter les arbres vides. On a le choix de le faire avant ou après l’insertion dans les ensembles. On choisit ici de le faire après, ce qui évite de faire un cas particulier pour un arbre qui serait intégralement vide.
def largeur(a):
    courant = []
    suivant = []
    courant.append(a)
    while len(courant) > 0:
        n = courant.pop()
        if n is None:
            continue
        print(n.valeur)
        suivant.append(n.gauche)
        suivant.append(n.droit)
        if len(courant) == 0:
            courant, suivant = suivant, []
Dessiner sur votre feuille 5 prénoms (Alice, Bob, Charles, Driss, Elsa) éparpillés de manière aléatoire. Voici leurs relations sur Instagram :
Alice suit Bob et Elsa.
Bob suit Alice.
Charles suit Alice et Driss.
Driss ne suit personne.
Elsa suit Bob et Charles.
Consigne : Représenter ces relations par des flèches sur leur cahier.
2. Pourquoi pas une liste ?
Nous avons vu les listes chaînées où chaque nœud a un seul suivant. Pourquoi est-ce que notre classe Cellule habituelle ne suffit pas pour modéliser cette situation ? »
3. Formalisation
Introduisez le vocabulaire de base en utilisant le dessin de correction :
Les personnes sont des ……………………………………….
Les flèches sont des ……………………………………………
L’ensemble s’appelle …………………………………………..
4. Comment coder ça ?
Si on devait créer une classe Sommet, à quoi ressemblerait son constructeur pour qu’on puisse retrouver ses abonnés ? »
class Sommet:
    def __init__(self, nom):
        ………………………………………….
        ………………………………………….

# Exemple de création
a = Sommet("Alice")
b = Sommet("Bob")
a.voisins.append(b) # Alice suit Bob
Exercice de clôture : Le Réseau des Développeurs
On considère le mini-graphe suivant représentant trois serveurs informatiques connectés :
Le serveur A est connecté au serveur B.
Le serveur B est connecté au serveur C.
Le serveur C est connecté au serveur A (c’est une boucle).
En utilisant la classe Sommet définie précédemment, écrivez les instructions Python permettant de créer ces trois serveurs et d’établir leurs connexions.
Si on exécute l’instruction print(a.voisins[0].voisins[0].nom), qu’est-ce qui va s’afficher à l’écran ?
Définition
Un graphe est un objet mathématique très simple avec lequel on peut faire des choses extrêmement compliquées. Il est constitué de sommets (ou nœuds) reliés par des arêtes (ou liens). Si les arêtes sont fléchées, on parle de graphe orienté sinon on parle de graphe non-orienté. Dans un graphe orienté, on appelle parents d’un nœud, les nœuds qui pointent vers lui. On appelle fils d’un nœud, les nœuds vers lesquels il pointe.
Un graphe peut représenter un réseau social, des liens d’amitié, un réseau routier.
1) Pour le graphe ci-dessous, dire s’il est orienté ou non, donner le nombre de sommets et le nombre d’arêtes.
C’est un graphe orienté (il y a des flèches). Il a 6 sommets et 8 arêtes.
2) Pour le graphe ci-dessous, dire s’il est orienté ou non, donner le nombre de sommets et le nombre d’arêtes.
C’est un graphe non-orienté (il n’y a pas de flèches). Il a 5 sommets et 6 arêtes.
On utilisera parfois des graphes pondérés pour représenter par exemple des distances sur une carte. Dans un tel graphe, les arêtes sont associées à un poids :
Propriétés
Les propriété les plus communes pour parler d’un graphe sont les suivantes :
une chaîne (ou chemin) est une suite d’arêtes consécutives ;
la longueur d’une chaîne est le nombre d’arêtes qui la compose ;
la distance entre deux sommets est la longueur de la chaîne la plus courte entre ces deux sommets ;
un cycle est une chaîne fermée composée d’arêtes distinctes. C’est à dire qui commence et termine par le même sommet et qui n’empreinte pas deux fois la même arête.
3) Pour le graphe ci-dessous, trouvez deux cycles. Donnez également la distance entre A et D.
Voici les trois cycles possibles : DCBD, DCEBD et CEBC. La distance entre A et B est 2.
Représentation
Nous avons utilisé intuituvement une représentation visuelle d’un graphe. Mais nous aurions pû utiliser une description textuelle d’un graphe. Par exemple pour celui de la question 2 :
A est relié à E ;
B est relié à C, D et E ;
C est relié à B, D et E ;
D est relié à C et B ;
E est relié à A, B et C.
4) Dessinez le graphe correspondant à la description ci-dessous :KevinMattéoTomEmmaClaireDavid
Tom est ami avec Emma, Claire et Mattéo ;
Claire est amie avec Tom, Emma et David ;
Mattéo est ami avec Tom et Kevin ;
Emma est amie avec Tom et Claire ;
David est ami avec Claire ;
Kevin est ami avec Mattéo.
5) Dessinez le graphe correspondant à la description ci-dessous :
A est à 12 km de B ;
B est à 12 km de A, 9 km de C et 25 km de D ;
C est à 9 km de B ;
D est à 25 km de B et 6 km de E ;
E est à 6 km de D.
Implémentations 1
On parle d’implémentation lorsqu’il s’agit de « représenter » un graphe dans un système informatique. Même si nous ne verrons pas directement comment on implémente un graphe en Python nous allons parler des deux principales implémentations d’un graphe.
Matrice d’adjacence
Une matrice n’est qu’un tableau à double entrée :
Nous avons ci-dessus une matrice à 3 lignes et 4 colonnes. En mathématiques on utilise les matrices pour effectuer des calculs, nous les utiliserons ici simplement comme des tableaux à deux dimensions.
Une matrice d’adjacence est une matrice carrée (même nombre de lignes que de colonnes) où chaque ligne et chaque colonne représentent un sommet. Pour un graphe non-orienté on mettra un « 1 » sur la case [i][j] s’il y a une arête entre le sommet i et le sommet j, et un « 0 » sinon. Pour un graphe orienté on mettra un « 1 » sur la case [i][j] s’il y a une arête du sommet i vers le sommet j, et un « 0 » sinon. Pour un graphe pondéré on mettra sur la case [i][j] le poids du lien entre le sommet i et le sommet j.
6) Donnez la matrice d’adjacence du graphe ci-dessous.
7) Donnez la matrice d’adjacence du graphe ci-dessous.
8) Donnez la matrice d’adjacence du graphe ci-dessous.
Listes d’adjacence
Pour un graphe non orienté, une liste d’adjacence associe à chaque sommet la liste de ses voisins. Par exemple, pour le graphe ci-dessous
La liste d’adjacence serait :
A → [B, C, E] ;
B → [A] ;
C → [A, D] ;
D → [C, E] ;
E → [A, D].
Pour un graphe orienté, une liste d’adjacence associe à chaque sommet la liste de ses successeurs. C’est à dire les sommets vers lesquels il pointe. Il est également possible de faire une liste d’adjacence des prédécesseurs, ou même les deux pour des raisons de symétrie.
9) Donnez la liste d’adjacence du graphe ci-dessous.
10) Donnez la liste d’adjacence des successeurs du graphe ci-dessous.
Choix d’implémentation
On utilisera une matrice d’adjacence dans le cas d’un graphe avec beaucoup de liens (on parle de graphe dense) et une liste d’adjacence dans le cas contraire. Cela permettra de gagner de la mémoire. Le choix peut aussi dépendre de l’utilité du graphe. En fonction de l’algorithme utilisé, on pourra préférer une implémentation à l’autre.
Implémentations 2
Nous avons vu dans ci-dessus, deux façons de représenter un graphe : par matrice d’adjacence ou par liste d’adjacence. Nous allons utiliser ces deux implémentations ici.
Matrice d’adjacence
Nous utiliserons le même graphe que le précédent :
1) Créez en Python la matrice d’adjacence de ce graphe.
2) (Dificile) Proposez une fonction matrice_largeur permettant de parcourir en largeur ce graphe. On utilisera une liste pour enregistrer les nœuds visités.
3) (Plus dificile) Proposez une fonction matrice_profondeur permettant de parcourir en profondeur ce graphe.
Liste d’adjacence
Nous utiliserons ici le même graphe que précédement.
4) Créez en Python les listes d’adjacence de ce graphe. (On utilisera un tableau à deux dimensions)
5) (Dificile) Proposez une fonction listes_largeur permettant de parcourir en largeur ce graphe. On utilisera une liste pour enregistrer les nœuds visités.
6) (Plus difficile) Proposez une fonction listes_profondeur permettant de parcourir en profondeur ce graphe.
programmes de référence
programme 1 : Graphe représenté par une matrice d’adjacence
class Graphe:
    """un graphe représenté par une matrice d’adjacence,
    où les sommets sont les entiers 0,1,...,n-1"""

    def __init__(self, n):
        self.n = n
        self.adj = [[False] * n for _ in range(n)]

    def ajouter_arc(self, s1, s2):
        self.adj[s1][s2] = True

    def arc(self, s1, s2):
        return self.adj[s1][s2]

    def voisins(self, s):
        v = []
        for i in range(self.n):
            if self.adj[s][i]:
                v.append(i)
        return v
programme 2 : Graphe représenté par un dictionnaire d’adjacence
class Graphe:
    """un graphe comme un dictionnaire d’adjacence"""

    def __init__(self):
        self.adj = {}

    def ajouter_sommet(self, s):
        if s not in self.adj:
            self.adj[s] = set()

    def ajouter_arc(self, s1, s2):
        self.ajouter_sommet(s1)
        self.ajouter_sommet(s2)
        self.adj[s1].add(s2)

    def arc(self, s1, s2):
        return s2 in self.adj[s1]

    def sommets(self):
        return list(self.adj)

    def voisins(self, s):
        return self.adj[s]
programme 3 : Coloriage glouton d’un graphe
def mex(voisins, couleur):
    """la plus petite couleur non utilisée par les voisins"""
    n = len(voisins)
    dispo = [True] * (n + 1)
    for v in voisins:
        if v in couleur and couleur[v] <= n:
            dispo[couleur[v]] = False
    for c in range(n + 1):
        if dispo[c]:
            return c

assert False # on n’arrivera jamais ici

def coloriage(g):
    """colorie graphe g avec un algorithme glouton"""
    couleur = {}
    n = 0
    for s in g.sommets():
        c = mex(g.voisins(s), couleur)
        couleur[s] = c
        n = max(n, c + 1)
    return couleur, n
Exercices
Exercice 1
Dessiner tous les graphes non orientés ayant exactement trois sommets.
Exercice 2
Combien y a-t-il de graphes orientés ayant exactement trois sommets ? On ne demande pas de les dessiner tous, mais seulement de les dénombrer.
Exercice 3
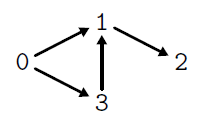
Ajouter à la classe Graphe du programme 1 (matrice d’adjacence) une méthode afficher pour afficher le graphe sous la forme suivante 0 -> 1 3 1 -> 2 3 2 -> 3 3 -> 1 c’est-à-dire une ligne par sommet, avec pour chacun la liste de ses voisins.
Exercice 4
Ajouter à la classe Graphe du programme 2 (dictionnaire d’adjacence) une méthode afficher pour afficher le graphe sous la forme suivante 0 {1, 3} 1 {2, 3} 3 {1} 2 {3} c’est-à-dire une ligne par sommet, avec pour chacun l’ensemble de ses voisins. L’ordre des sommets n’est pas important. L’ensemble des voisins peut être affiché directement avec print.
Exercice 5
Ajouter à la classe Graphe du programme 2 une méthode nb_sommets() qui donne le nombre de sommets du graphe.
Exercice 6
Ajouter à la classe Graphe du programme 1 une méthode degre(s) qui donne le nombre d’arcs issus du sommet s. On appelle cela le degré du sommet s.
Exercice 7
En utilisant l’exercice précédent, ajouter à la classe Graphe du programme 36 une méthode nb_arcs() qui donne le nombre total d’arcs du graphe.
Exercice 8
Ajouter à la classe Graphe du programme 2 une méthode degre(s) qui donne le nombre d’arcs issus du sommet s. On appelle cela le degré du sommet s.
Exercice 9
En utilisant l’exercice précédent, ajouter à la classe Graphe du programme 2 une méthode nb_arcs() qui donne le nombre total d’arcs du graphe.
Exercice 10
Ajouter aux classes Graphe des programmes 1 et 2 une méthode supprimer_arc(s1, s2) pour supprimer l’arc entre les sommets s1 et s2. S’il n’y a pas d’arc entre ces sommets, la méthode n’a aucun effet. On supprime un élément d’un ensemble avec sa méthode remove.
Exercice 11
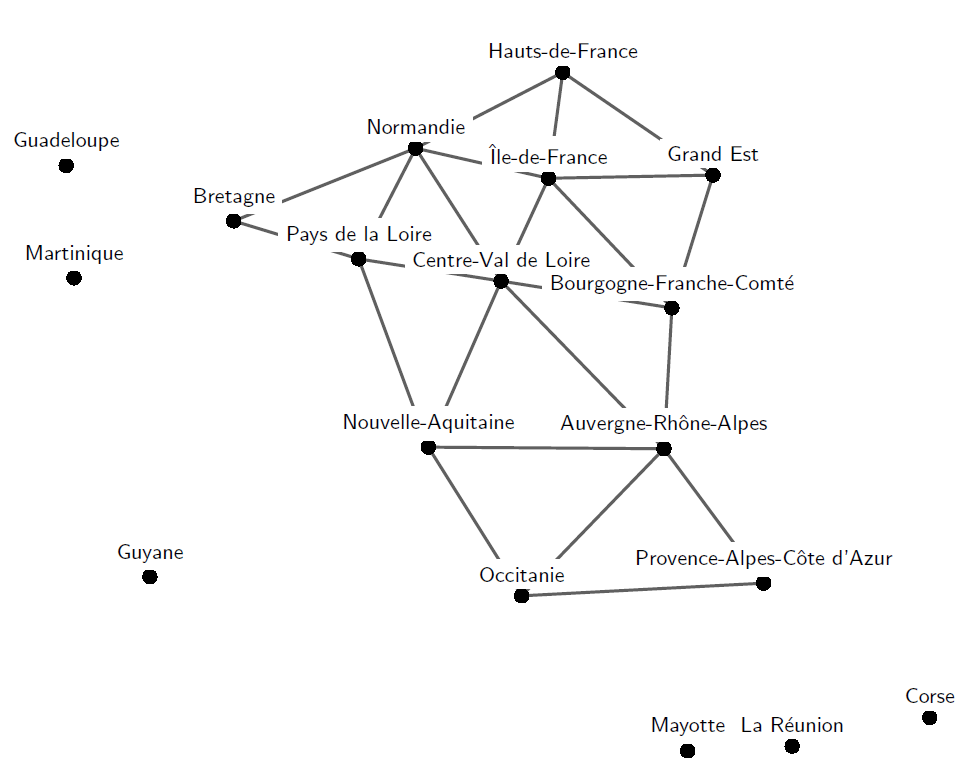
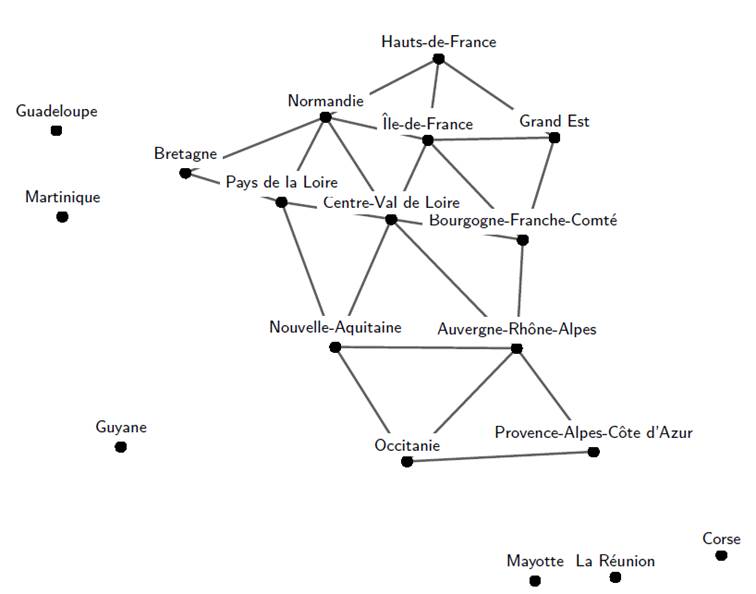
Donner une coloration du graphe des régions ci-dessous qui n’utilise que quatre couleurs.
Corrections
Exercice 1
Il y en a 8 au total
Exercice 2
Il y a six arcs possibles (0 → 1, 1 → 0, 1 → 2, 2 → 1, 2 → 0, 0 → 2), chacun pouvant être présent ou absent, soit 26 = 64 possibilités au total.
Exercice 3
def afficher(self):
     for s in range(self.n):
     print(s, "->", end="")
     for v in range(self.n):
          if self.adj[s][v]:
               print("", v, end="")
     print()
Exercice 4
On fait un cas particulier pour l’ensemble vide, histoire qu’il ne soit pas affiché comme set() mais comme {}.
def afficher(self):
     for s in self.adj:
          if len(self.adj[s]) == 0:
               print(s, "{}")
          else:
               print(s, self.adj[s])
Exercice 5
Le nombre de sommets est égal au nombre d’entrées dans le dictionnaire :
def nb_sommets(self):
     return len(self.adj)
Exercice 6
Le code est très semblable à celui de la méthode voisins :
def degre(self, s):
     d = 0
     for i in range(self.n):
          if self.adj[s][i]:
               d += 1
     return d
Exercice 7
Il suffit de faire la somme de tous les degrés.
def nb_arcs(self):
     n = 0
     for s in range(self.n):
          n += self.degre(s)
     return n
Exercice 8
C’est exactement le cardinal de l’ensemble adj[s] :
def degre(self, s):
     return len(self.adj[s])
Exercice 9
Comme dans l’exercice 7, on fait la somme de tous les degrés.
def nb_arcs(self):
     n = 0
     for s in self.adj:
          n += self.degre(s)
     return n
Exercice 10
Pour la matrice d’adjacence, on affecte le booléen False dans la matrice :
Les vieux grincheux vous le répéteront encore et encore, l’état actuel de la musique est cataclysmique. Ils pourront vous citer des exemples à la pelle et se lamenter que des morceaux aussi médiocres soient autant écoutés sur Spotify et autres plateformes de consommation musicale. Pour renforcer leur argument ils vous citeront un grand nombre de chef d’œuvre obscures ayant marqués leurs jeunes années, et vous diront « ça, ça c’était de la musique ». Contrairement à ce que ces passéistes peuvent croire, le problème ne date pas d’aujourd’hui.
L’essentiel de la musique populaire n’est pas composé par les artistes qui l’interprètent, mais par des petits génies ayant un doigt sur le pouls de la culture et sachant adapter leurs petites recettes à l’humeur générale. Même les bons groupes, après un deux ou trois albums novateurs et un nombre substantiel de fans accumulés, troquent l’ébullition et la créativité débridée de leurs premières années pour un pilote automatique leur permettant répliquer leur recette encore et encore pour leur public de futur nostalgiques/passéistes. Ceci dit, qu’on les apprécie ou non, tous ces producteurs, compositeurs et interprètes, tous ces groupes et artistes solos, ont passé des années à développer la maitrise de leur champ de compétence.
Avec les capacités croissantes des ordinateurs, de nombreux logiciels sont apparus pour faciliter la vie des musiciens, et réduire les coûts d’enregistrement. Il n’a jamais été aussi abordable de créer et d’enregistrer de la musique. Avec l’apparition de FrutyLoops, GarageBand et autres, la production musicale est devenue un jeu d’enfant. Les absences de culture, et de compétences sont effacée par l’ordinateur prenant le relai (coupage, collage, variation de vitesse, correction de pitch pour les enregistrements, arpégiateurs, …)
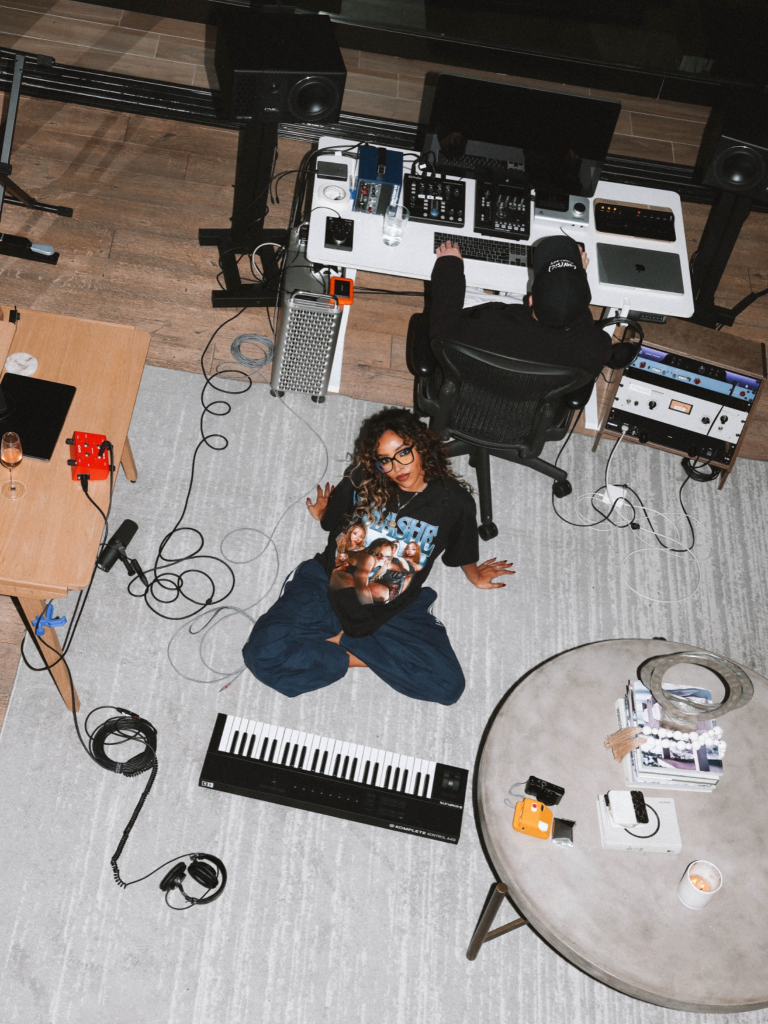
après avoir composé ses premiers titres sur ordinateur portable dans sa chambre, Tinashe doit se sentir comme à la maison !
Les IA destinées à la production musicales comme SUNO, UDIO, ElevenLabs s’inscrivent en continuité de ce mouvement. Les utilisateurs ont besoin d’encore moins de compétence et de temps pour obtenir des résultats d’un niveau professionnel. C’est aussi en rupture de l’évolution des techniques de « création » musicale, car la machine ne se contente plus d’assister le créatif, elle le remplace partiellement ou totalement. En appuyant sur un bouton l’IA peut créer un morceau de A à Z à votre place. Il sera bien fichu mais très générique. Vous pouvez personnaliser ça en donnant des indications sur ce que vous voulez obtenir en termes d’accompagnement : style de musique, instruments, tempo, atmosphère, clé, mode ; ou en termes de paroles : indications générales pour le générateur automatique de paroles, ou texte à compléter ou entier.
L’intelligence artificielle en analysant des millions de titres, a appris à deviner quelle est la note la plus appropriée après une séquence, ou quel genre de refrain mettre après un couplet, quel rythme donner à une suite de syllabe. Il le fait en suivant ce qui a été le plus populaire jusqu’ici. Les morceaux générés sont la synthèse d’une recette magique jamais énoncée mais utilisée inconsciemment par des millions de musiciens. Chaque nouvelle génération est unique mais avec un grand nombre de paramètres, les variations sont limitées, et on va avoir des sorties très ressemblantes.
Il y a bien des raisons de faire de la musique : faire danser les gens, contribuer à la beauté du monde, vous exprimer en partageant vos sentiments ou vos idées, faire de l’argent, trouver sa place dans un milieu, être validé, admiré, devenir célèbre… avec la démocratisation des logiciels de création musicale, l’offre semble devenir infinie, par contre la quantité de temps disponible pour écouter que ce soit au niveau individuel comme collectif est beaucoup plus limité.
Même si on aime le confort des mélodies qui vont bien ensemble, les auditeurs cherchent quelque chose de plus, quelque chose qui leur parle personnellement, et en miroir, quelque chose qui leur permettra de rejoindre une grande famille de gens comme eux. Être unique c’est polarisant, ça passe ou ça casse et en général ça casse. On a du mal à gérer ce qui est trop éloigné de nous. Par contre quand ça passe, c’est un coup de cœur, ça crée un lien potentiellement durable. Les morceaux génériques peuvent marcher auprès du public mais seulement si on y met les grands moyens : artistes célèbres pour les interpréter, vidéoclip onéreux, campagne de pub moderne (placement de produit, création artificielle de tendance avec des bots, vidéos virales, …) N’ayant pas ces moyens on va travailler pour avoir des productions les plus uniques possible et les plus personnelles. Et même si ça semble contreproductif, de s’investir dans un projet qui parlera à 0,1% des gens, le monde est grand et donc 0,1% de 8,3 milliards ça fait quand même 8,3 millions de fans potentiels !
Activité suivie (sur 3,5 +2,5 séances de 60 minutes)
Objectif : à moins que vous vouliez produire les morceaux en votre nom propre le but est en plusieurs parties :
de créer un artiste virtuel unique (chanteur/rappeur, poète, songwriter), et générer deux titres aussi spécifiques et uniques que possibles.
Présenter à l’oral votre production pendant une dizaine de minutes
La personna de votre artiste virtuel (qui est il ? quelles sont ses valeurs ? son style de vie, ses marques, son histoire,
Au moins deux morceaux, en quoi sont-ils uniques ? Parler de votre connexion personnelle avec ceux-ci.
Parler brièvement de votre technique pour créer vos morceaux.
Vous passerez en fin de séquence faire une présentation orale s’appuyant sur un PDF ou un powerpoint contenant la préparation de la présentation : image, texte, liens vers les chansons. Deux notes : une pour la préparation, y compris la création de vos morceaux, et une pour la prestation orale.
Pour cette activité vous aurez besoin de créer un compte ChatGPT (généralement vous en avez déjà un, mais on ne sait jamais) et un compte SUNO (qui vous donnera 5 générations de morceaux par jour). Il vous faudra connaitre vos mots de passe afin de pouvoir utiliser ces deux applications sur n’importe quel ordinateur et sur vos téléphones portables. Vous aurez aussi besoin d’une clé USB (avec 500Mo de libre) que vous garderez dans votre trousse jusqu’à la fin de l’année.
Rôle de ChatGPT pour l’activité :
Découverte de l’art du prompt : plus vous êtes clairs dans vos questions plus les réponses seront intéressantes.
Si vous avez besoin d’explication, et d’idées sur n’importe quel sujet.
Si vous voulez mettre une idée sous forme de texte de chansons.
Il vous servira à générer des images pour illustrer votre morceau (pochette d’album, concept art pour un clip, description visuelle du monde évoqué par le morceau), comme votre artiste virtuel
Rétro engenieering de chansons : si vous avez un titre que vous aimez beaucoup et que vous voudriez que SUNO s’en inspire, vous pouvez lui demander de générer un prompt lié au morceau total ou uniquement à la partie de celui-ci que vous voulez émuler.
Séance 1 :
Présentation de l’activité
Création des comptes SUNO et ChatGPT
Pour chatGPT : expérimenter des prompts pour créer des images, du discours, des textes de chanson
Retro engenieering d’une chanson populaire
Génération de votre première chanson avec SUNO avec le texte généré avec ChatGPt et un prompt obtenu par retro engenieering.
Ecoute et évaluation de cette chanson, est ce que le texte sonne bien ? est ce qu’il doit être changé par endroit ? Musicalement qu’est ce qui vous convient ? Qu’est ce qui pose problème ? avec ChatGPT obtenez un prompt mieux adapté. Génération d’une nouvelle version. Et d’une nouvelle etc jusqu’à épuisement des crédits. En affinant votre production.
Attention : si vous avez une certaine latitude au niveau de la vulgarité de votre texte, ceux-ci ne doivent pas contenir de propos racistes, misogynes, homophobes, antisémites… pas plus que d’incitation à l’utilisation de drogues.
Si vous avez encore du temps, vous pourrez générer une illustration d’album pour votre titre.
L’image générée, le texte et le titres musical seront à conserver et inclus dans l’annexe de votre document à rendre en fin de séquence.
Séance 2
On va générer une nouvelle chanson en suivant la méthode de la séance précédente, mais en rendant votre démarche plus personnelle (vous pourrez utiliser un texte écrit de A à Z chez vous ou en classe, si vous n’êtes pas à l’aise dans votre expression, vous pouvez vous concentrer sur les idées, sur l’ambiance, pui collaborer plus finement avec ChatGPT pour construire quelque chose de personnel), Avec un rendu qui sera aussi inclus dans le document powerpoint à rendre. Document dont vous commencerez la rédaction.
Vous commencerez à travailler sur la personna de votre artiste virtuel, en générant photo, biographie,…
(durant cette séance vous ferez au moins une des activités IA disponibles sur le site)
Séance 3
La même chose que la séance 2, en continuant d’affiner votre approche et de faire un travail de plus en plus personnel. On finalise le power point. On commence à s’entrainer à la présentation.
Si vous avez un artiste virtuel, il sera interessant de vous débrouiller pour que sa voix soit aussi constante que possible. Pour cela il faudra être attentif aux prompt et ne pas hésiter à utiliser la fonction persona de SUNO.
Séance 4
On commence par faire passer les volontaires. Discussion sur ce qui va et ne va pas dans :
La prestation orale
Les morceaux
La persona
Pour chaque prestation orale, sur leur cahier où une feuille à conserver précieusement, vous noterez le nom de la personne faisant la présentation des notes sur 100 des trois items cité audessus ainsi qu’un petit texte indiquant ce que vous avez préféré (ou ce qui vous a marqué positivement) et ce que vous avez le moins apprécié (Votre feuille de note est susceptible d’être ramassée).
Après le passage des volontaires, les élèves peuvent peaufiner leur projet, créer d’autres titres, améliorer leur powerpoint. D’ailleurs ce fichier sera à rendre en fin de séance sur pronote.
Séance 5 et 6
Les élèves qui ne sont pas encore passé le feront dans l’ordre alphabétique. Si l’élève refuse de passer, ou s’il a une absence non justifiée durant la séance durant laquelle il doit passer, il passera la suivante en perdant automatiquement un certain nombre de points (sans doute 5).
Après ça, vous remplirez un questionnaire en ligne et vous marquerez les notes mises à vos camarades.
C’est terminé … mais ça n’est que le début…
Pour les 6 élèves les plus motivés, vous vous partagerez les élèves de la classe de manière relativement équitable (mais personne ne doit être laissé derrière). Vous allez devenir patron d’un label virtuel en charge de la promotion de ces artistes. Vous obtiendrez d’eux leurs illustrations ainsi que leurs morceaux. Vous allez créer une chaine musicale sur Youtube, et vous posterez au moins un morceau des élèves que vous aurez choisi (vous pouvez créer une vidéo avec le logiciel gratuit ClipChamp ou avec des plateformes qui permettrons de visualiser les paroles : ). Il vous faudra créer un logo pour votre label, et un petit texte expliquant votre philosophie.
Une fois que c’est fait, à travers vos amis, vos relations, vos réseaux vous allez promouvoir votre label et vos artistes (ces derniers pourront aussi promouvoir leurs productions) Il y aura un petit concours de vues pour savoir qui a le mieux assuré la promotion de ses artistes.
Pour tout le monde : quelque mois plus tard vous allez créer une page WEB présentant votre artiste (ou vos artistes si vous êtes un patron de label) qui sera mise en ligne.
Pour ceux qui sont très content de ce qu’ils ont fait et on envie de poursuivre dans cette voie vous pouvez utiliser un service de mise en ligne comme DistroKid qui vous permettra d’être présent sur la majeure partie des plateformes de streaming. C’est fastidieux mais ça n’est pas bien cher.
Bonus :
Emerveillé par les possibilité de SUNO, en parallèles à la création de l’activité, j’ai passé trois mois à créer des morceaux. En dehors de « je t’ai dans la peau » et « 4 saisons » j’ai écris 100% des paroles et j’ai « prompté » les habillages sonores en m’inspirant de mes morceaux préférés.
Un parcours de graphe est un algorithme consistant à explorer tous les sommets d’un graphe de proche en proche à partir d’un sommet initial donné. Cela généralise les parcours des arbres binaires que vous avez déjà vus.
Ces parcours sont notamment utilisés pour rechercher un plus court chemin (routage sur Internet, applications de navigation dans un réseau de métros ou de trains) ou pour trouver la sortie d’un labyrinthe.
Dans un parcours en largeur, on progresse par « cercles concentriques » à partir du sommet de départ. On visite d’abord tous les sommets à une distance de 1 unité du point départ, puis tous les sommets à une distance de 2 unités, etc. (en considérant que la distance est le nombre d’arêtes).
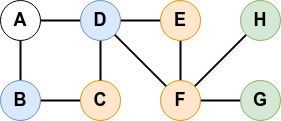
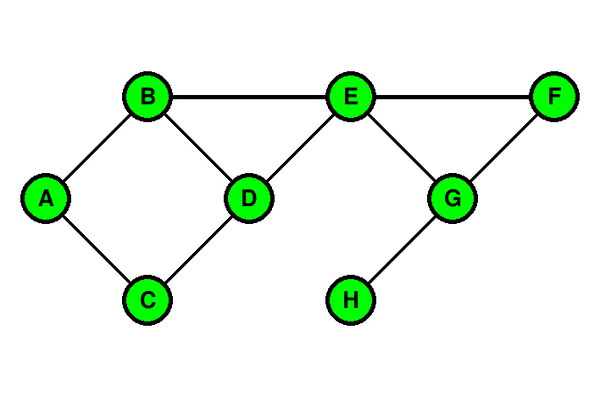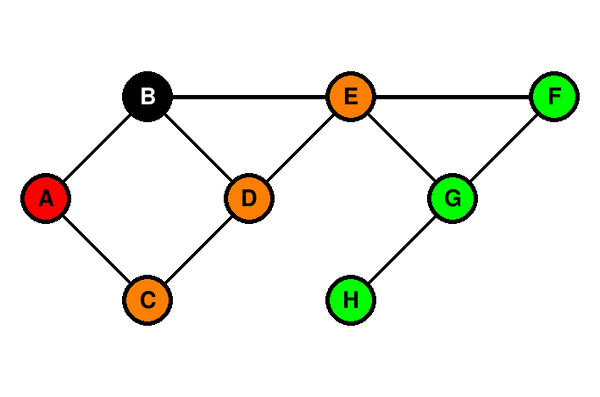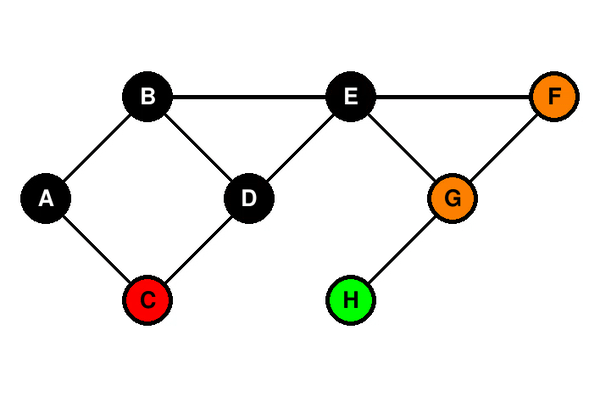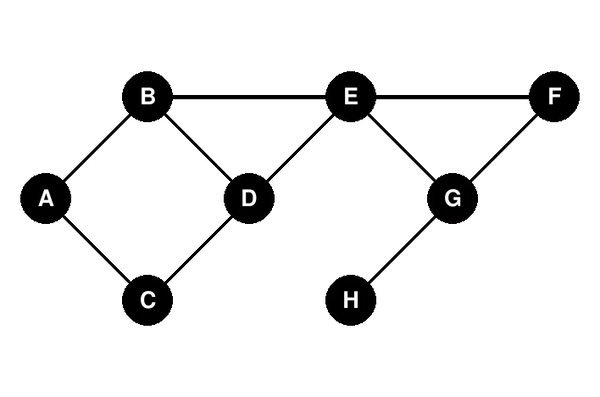
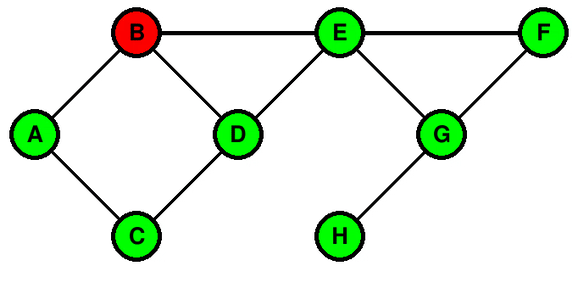
Par exemple, avec le graphe suivant,
le parcours en largeur au départ de A donne la liste suivante des sommets :
A ; B ; D ; C ; E ; F ; G ; H
(avec la convention que, quand il y a plusieurs sommets à la même distance, on les écrit dans l’ordre alphabétique).
Exercice 1
Effectuer le parcours en largeur du graphe représenté ci-dessous, en partant du sommet A.
Solution
Le résultat du parcours en largeur est : A ; B ; C ; E ; D ; G ; F.
Exercice 2
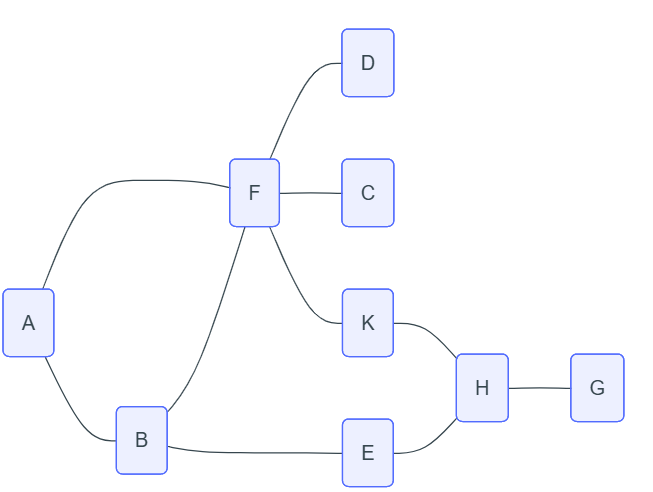
Effectuer le parcours en largeur du graphe représenté ci-dessous, en partant du sommet D.
Solution
Le résultat du parcours en largeur est : D ; F ; A ; B ; C ; K ; E ; H ; G.
Parcours en profondeur
Dans un parcours en profondeur, l’idée est de suivre un chemin le plus loin possible. Si on arrive au bout d’un chemin, on revient à la bifurcation précédente pour explorer un nouveau chemin.
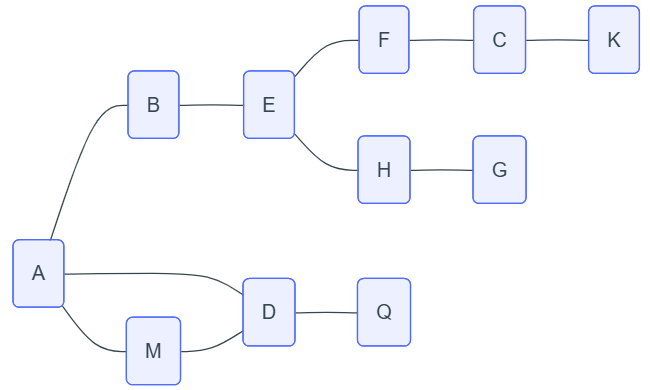
Par exemple, avec le graphe suivant :
un parcours en profondeur au départ du sommet A donne :
A ; B ; E ; F ; C ; K ; H ; G ; D ; Q ; M.
Exercice
Le mécanisme d’un parcours en profondeur est encore plus explicite dans le cas des graphes orientés.
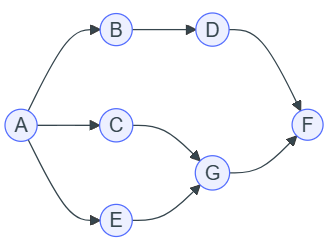
Effectuer le parcours en profondeur du graphe représenté ci-dessous, en partant du sommet A.
Solution
Le résultat du parcours en profondeur est : A ; E ; G ; F ; C ; B ; D.
Les deux types de parcours (en largeur et en profondeur) reposent sur le même principe de base :
Le sommet de départ dep étant donné, on crée une structure V qui contiendra au départ uniquement ce sommet dep .
Tant que V n’est pas vide :
on choisit un sommet s existant dans V ;
on visites, c’est-à-dire qu’on l’affiche ;
on ajoute à V tous les voisins de spas encore découverts.
La structure V sert donc à mémoriser les sommets qui ont été découverts mais pas encore visités.
Si on choisit une file (FIFO), on visitera les sommets dans l’ordre d’arrivée, donc les plus proches du sommet précédent. On obtient donc un parcours en largeur ( Breadth First Search, ou BFS).
Si on choisit une pile (LIFO), on visitera d’abord les derniers sommets arrivés, donc on parcourt le graphe en visitant à chaque étape un voisin du précédent. On obtient donc un parcours en profondeur ( Depth First Search, ou DFS).
Voici une illustration du parcours en largeur d’un graphe avec B comme sommet de départ :
Codes couleur :
vert : les sommets non encore traités.
rouge : le sommet en cours de traitement.
orange : la file d’attente des sommets qui seront bientôt traités. On y rajoute à chaque fois les voisins du sommet en cours de traitement, uniquement si ils n’ont pas encore été découverts.
noir : les sommets traités.
Le résultat du parcours en largeur du graphe est donc : B ; A ; D ; E ; C ; F ; G ; H
Remarque : quand on ajoute plusieurs voisins d’un seul coup dans la file, on fait ici le choix de les ajouter dans l’ordre alphabétique.
Un outil en ligne
Un outil en ligne, permet de visualiser le résultat du parcours en profondeur (DFS : depth first search) d’un graphe.
Un graphe est donné en exemple, mais vous pouvez le modifier ou construire le vôtre :
Dans les menus déroulants, bien choisir Algorithm : BFS et Example graph : directedGraph
Remarque : ce code est donné uniquement à titre illustratif : il n’est pas nécessaire de l’apprendre par cœur. Par ailleurs, dans une partie cachée, il y a le codage des primitives des files et des graphes.
def parcours_largeur(G,s):
f = creer_file_vide()
enfiler(f,s)
tab_decouverts = [s]
while not est_vide(f):
s = defiler(f)
print(s, end=" - ")
for v in liste_voisins(G,s) :
if v not in tab_decouverts :
enfiler(f,v)
tab_decouverts.append(v)
return None
# modélisation du graphe par un dictionnaire
graphe = {"B" : ["A", "D", "E"], "A" : ["B", "C"], "C" : ["A", "D"], "D":["B", "C", "E"],
"E" : ["B", "F", "G"], "F" : ["E", "G"], "G" : ["E", "F", "H"], "H":["G"]}
# parcours du graphe
parcours_largeur(graphe, "B")
Rappel : dans un parcours en profondeur, chaque nouveau voisin découvert est ajouté au sommet d’une pile.
On prend comme exemple le même graphe que dans l’exemple précédent, avec un départ du sommet B. On convient que, quand il y a plusieurs sommets à empiler en même temps, on les empile dans l’ordre alphabétique.
B est visité et on empile les voisins de B : la pile contient alors A (bas de la pile), D, E (sommet de la pile).
E est dépilé (il est visité) et on empile ses voisins qui ne sont pas déjà dans la pile : la pile contient alors A (bas de la pile), D, F, G (sommet de la pile).
G est dépilé (il est visité) et on empile H, son seul voisin pas encore découvert : la pile contient alors A (bas de la pile), D, F, H (sommet de la pile).
H est dépilé et il n’y a pas de nouveau voisins à empiler : la pile contient alors A (bas de la pile), D, F (sommet de la pile).
et ainsi de suite
Au final, on obtient l’ordre de visite suivant : B ; E ; G ; H ; F ; D ; C ; A.
2.4. Codage d’un parcours en profondeur en Python⚓︎
Remarque : ce code est donné uniquement à titre illustratif : il n’est pas nécessaire de l’apprendre par cœur.
def parcours_profondeur(G,s):
p = creer_pile_vide()
empiler(p,s)
tab_decouverts = [s]
while not est_vide(p):
s = depiler(p)
print(s, end=" - ")
for v in liste_voisins(G,s) :
if v not in tab_decouverts :
empiler(p,v)
tab_decouverts.append(v)
return None
# modélisation du graphe par un dictionnaire
graphe = {"B" : ["A", "D", "E"], "A" : ["B", "C"], "C" : ["A", "D"], "D":["B", "C", "E"],
"E" : ["B", "F", "G"], "F" : ["E", "G"], "G" : ["E", "F", "H"], "H":["G"]}
# parcours du graphe
parcours_profondeur(graphe, "B")
On donne ci-dessous le code d’un graphe non orienté graphe1.
En comparant les résultats des appels des fonctions liste_sommets et parcours depuis le sommet A (soit en largeur, soit en profondeur), déterminer si ce graphe est connexe ou pas.
Solution : On observe que le parcours du graphe depuis le sommet A fournit moins de sommets que la liste des sommets. Ce graphe n’est donc pas connexe.
Sommet atteignable ou pas ?
On donne ci-dessous le code d’un graphe connexe orienté graphe2.
En effectuant un parcours depuis le sommet A (soit en largeur, soit en profondeur), déterminer s’il est possible d’atteindre le sommet B depuis ce sommet A.
Ce même sommet B est-il atteignable depuis le sommet N ?
# modélisation d'un graphe par un dictionnaire
graphe2 = {
"A": ["G", "K", "L"], "B": ["L", "N"], "C": ["A", "D", "I"], "D": ["C"], "E": ["D", "F", "G"],
"F": ["H"], "G": ["D"], "H": ["E", "G"], "I": ["A", "G", "H"], "J": ["B", "M", "N"],
"K": ["I"], "L": [], "M": ["B"], "N": ["M"]
}
# dans ce graphe orienté, est-il possible d'aller de A vers B ? et de N vers B ?
Solution
On observe que le sommet B n’apparait pas dans le parcours du graphe depuis le sommet A : B n’est donc pas atteignable depuis A.
Mais B est atteignable depuis le sommet N, comme le montre un parcours depuis N.
Il faudra aussi charger dans Basthon les trois modules Python suivants (Ouvrir… puis Installer le module) : laby2d.py, laby3d.py et solution.py.
4. Algorithme de recherche d’un plus court chemin : algorithme de Dijkstra⚓︎
Vous avez déjà effectué la recherche d’un plus court chemin dans un graphe pondéré, quand il s’agissait de trouver le chemin emprunté pour aller d’un routeur A à un routeur B selon le protocole OSPF.
On peut systématiser la détermination du plus court chemin d’un point à un autre en appliquant l’algorithme de Dijkstra (mis au point par Edsger Dijkstra en 1959), comme expliqué dans la vidéo suivante :
Application de l’algorithme de Dijkstra
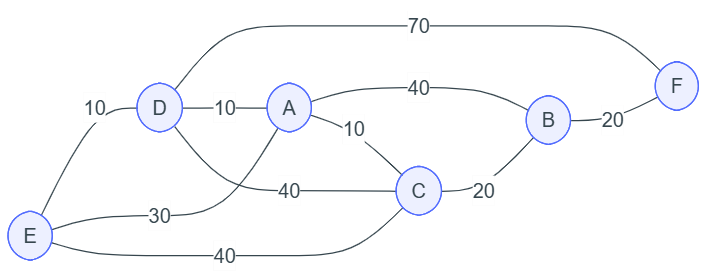
Donner le plus court chemin pour aller de E à F dans le graphe ci-dessous :
Solution
E
A
B
C
D
F
Choix
0
—
—
—
—
—
E(0)
.
30 vE
—
40 vE
10 vE
—
D(10)
.
20 vD
—
40 vE
.
80 vD
A(20)
.
.
60 vA
30 vA
.
80 vD
C(30)
.
.
50 vC
.
.
80 vD
B(50)
.
.
.
.
.
70 vB
F(70)
Le meilleur trajet est donc E-D-A-C-B-F, pour une distance totale de 70. Attention ce trajet correspond à la colonne choix (dans l’ordre) mais ce n’est pas toujours le cas.
Deuxième application de l’algorithme de Dijkstra
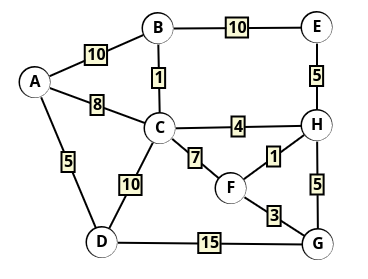
Déterminer le plus court chemin entre A et G dans le graphe pondéré ci-dessous (en version papier).
Solution
A
B
C
D
E
F
G
H
Choix
0
—
—
—
—
—
—
—
A(0)
.
10 vA
8 vA
5 vA
—
—
—
—
D(5)
.
10 vA
8 vA
.
—
—
20 vD
—
C(8)
.
9 vC
.
.
—
15 vC
20 vD
12 vC
B(9)
.
.
.
.
19 vB
15 vD
20 vD
12 vC
H(12)
.
.
.
.
17 vH
13 vH
17 vH
.
F(13)
.
.
.
.
17 vH
.
16 vF
.
G(16)
Le meilleur trajet est donc A – C – H – F – G, pour une distance totale de 16.
L’algorithme de Dijkstra, ici exécuté de manière manuelle, est bien sûr programmable. Mais cela dépasse le niveau attendu en fin de Terminale.
class Graphe:
"""un graphe représenté par une matrice d’adjacence,
où les sommets sont les entiers 0,1,...,n-1"""
def __init__(self, n):
self.n = n
self.adj = [[False] * n for _ in range(n)]
def ajouter_arc(self, s1, s2):
self.adj[s1][s2] = True
def arc(self, s1, s2):
return self.adj[s1][s2]
def voisins(self, s):
v = []
for i in range(self.n):
if self.adj[s][i]:
v.append(i)
return v
Graphe représenté par un dictionnaire d’adjacence
class Graphe:
"""un graphe comme un dictionnaire d’adjacence"""
def __init__(self):
self.adj = {}
def ajouter_sommet(self, s):
if s not in self.adj:
self.adj[s] = set()
def ajouter_arc(self, s1, s2):
self.ajouter_sommet(s1)
self.ajouter_sommet(s2)
self.adj[s1].add(s2)
def arc(self, s1, s2):
return s2 in self.adj[s1]
def sommets(self):
return list (self.adj)
def voisins(self, s):
return self.adj[s]
Exercice 1 Dessiner tous les graphes non orientés ayant exactement trois sommets.
Solution : 8 au total :
Exercice 2 Combien y a-t-il de graphes orientés ayant exactement trois sommets ? On ne demande pas de les dessiner tous, mais seulement de les dénombrer.
Solution : Il y a six arcs possibles (0 → 1, 1 → 0, 1 → 2, 2 → 1, 2 → 0, 0 → 2), chacun pouvant être présent ou absent, soit possibilités au total.
Exercice 3 Ajouter à la classe Graphe du programme matrice d’adjacence donné avant les consignes des exercices, une méthode afficher pour afficher le graphe sous la forme suivante
0 -> 1 3
1 -> 2 3
2 -> 3
3 -> 1
c’est-à-dire une ligne par sommet, avec pour chacun la liste de ses voisins.
def afficher(self):
for s in range(self.n):
print(s, "->", end="")
for v in range(self.n):
if self.adj[s][v]:
print("", v, end="")
print()
Exercice 04 Ajouter à la classe Graphe du programme dictionnaired’adjacence donné avant les consignes des exercices une méthode afficher pour afficher le graphe sous la forme suivante
0 {1, 3}
1 {2, 3}
3 {1}
2 {3}
c’est-à-dire une ligne par sommet, avec pour chacun l’ensemble de ses voisins.
L’ordre des sommets n’est pas important. L’ensemble des voisins peut être affiché directement avec print.
Correction : On fait un cas particulier pour l’ensemble vide, histoire qu’il ne soit pas affiché comme set() mais comme {}.
def afficher(self):
for s in self.adj:
if len(self.adj[s]) == 0:
print(s, "{}")
else:
print(s, self.adj[s])
Exercice 05 Ajouter à la classe Graphe du programme dictionnaired’adjacence donné avant les consignes des exercices une méthode nb_sommets() qui donne le nombre de sommets du graphe.
Correction : Le nombre de sommets est égal au nombre d’entrées dans le dictionnaire :
def nb_sommets(self):
return len(self.adj)
Exercice 06 Ajouter à la classe Graphe du programme matriced’adjacence donné avant les consignes des exercices une méthode degre(s) qui donne le nombre d’arcs issus du sommet s. On appelle cela le degré du sommet s.
Correction : Le code est très semblable à celui de la méthode voisins :
def degre(self, s):
d = 0
for i in range(self.n):
if self.adj[s][i]:
d += 1
return d
Exercice 07 En utilisant l’exercice précédent, ajouter à la classe Graphe du programme matriced’adjacence donné avant les consignes des exercices une méthode nb_arcs() qui donne le nombre total d’arcs du graphe.
Correction : Il suffit de faire la somme de tous les degrés.
def nb_arcs(self):
n = 0
for s in range(self.n):
n += self.degre(s)
return n
Exercice 08 Ajouter à la classe Graphe du programme dictionnaired’adjacence donné avant les consignes des exercices une méthode degre(s) qui donne le nombre d’arcs issus du sommet s. On appelle cela le degré du sommet s.
Correction : C’est exactement le cardinal de l’ensemble adj[s] :
def degre(self, s):
return len(self.adj[s])
Exercice 09 En utilisant l’exercice précédent, ajouter à la classe Graphe du programme dictionnaired’adjacence donné avant les consignes des exercices une méthode nb_arcs() qui donne le nombre total d’arcs du graphe.
Correction : comme il y a deux exercice, on fait la somme de tous les degrés.
def nb_arcs(self):
n = 0
for s in self.adj:
n += self.degre(s)
return n
Exercice 10 Ajouter aux classes Graphe des programmes dictionnaire et matrice d’adjacence une méthode supprimer_arc(s1, s2) pour supprimer l’arc entre les sommets s1 et s2. S’il n’y a pas d’arc entre ces sommets, la méthode n’a aucun effet. On supprime un élément d’un ensemble avec sa méthode remove.
Correction : Pour la matrice d’adjacence, on affecte le booléen False dans la matrice :
Pour le dictionnaire d’adjacence, on supprime s2 de l’ensemble des voisins de s1, si l’arc existe :
def supprimer_arc(self, s1, s2):
     if self.arc(s1, s2):
          self.adj[s1].remove(s2)
Exercice 11 Donner une coloration du graphe des régions ci-dessus qui n’utilise que quatre couleurs.
Correction : Il suffit de reprendre les couleurs obtenues avec l’algorithme glouton (figure 11.2 page 204) et de faire seulement deux changements :
Bretagne 1 (au lieu de 0)
Normandie 0 (au lieu de 4)
Exercice 12 : coloriage de graphes
écrivons un programme qui colorie un graphe avec un algorithme glouton. Colorier un graphe veut dire associer une couleur à chacun de ses sommets, de façon à ce que deux sommets reliés par un arc n’aient pas la même couleur. Colorier un graphe avec un minimum de couleurs est un problème difficile, mais si on accepte l’idée d’utiliser éventuellement plus de couleurs que nécessaire, alors on peut colorier un graphe efficacement. Le principe d’un coloriage glouton est simple. On parcourt les sommets dans un ordre arbitraire et, pour chaque sommet, on lui attribue la première couleur qui n’est pas utilisée par ses voisins.
def mex(voisins, couleur):
    """la plus petite couleur non utilisée par les voisins"""
    n = len(voisins)
    dispo = [True] * (n + 1)
    for v in voisins:
        if v in couleur and couleur[v] <= n:
            dispo[couleur[v]] = False
    for c in range(n + 1):
        if dispo[c]:
            return c
        assert False # on n’arrivera jamais ici

def coloriage(g):
    """colorie graphe g avec un algorithme glouton"""
    couleur = {}
    n = 0
    for s in g.sommets():
        c = mex(g.voisins(s), couleur)
        couleur[s] = c
        n = max(n, c + 1)
    return couleur, n
programmes de référence :
Programme 39 — Parcours en profondeur
def parcours(g, vus, s):
    """parcours en profondeur depuis le sommet s"""
    if s not in vus:
        vus.add(s)
    for v in g.voisins(s):
        parcours(g, vus, v)

def existe_chemin(g, u, v):
    """existe-t-il un chemin de u à v ?"""
    vus = set()
    parcours(g, vus, u)

def parcours(g, vus, s):
    """parcours en profondeur depuis le sommet s"""
    if s not in vus:
        vus.add(s)
    for v in g.voisins(s):
        parcours(g, vus, v)

def existe_chemin(g, u, v):
    """existe-t-il un chemin de u à v ?"""
    vus = set()
    parcours(g, vus, u)
    return v in vus
Programme 40 — Parcours en profondeur avec une pile
def parcours(g, vus, s):
    """parcours en profondeur depuis le sommet s"""
    pile = Pile()
    pile.empiler(s)
    while not pile.est_vide():
    s = pile.depiler()
    if s in vus:
        continue
    vus.add(s)

for v in g.voisins(s):
    pile.empiler(v)
Programme 41 — Détecter la présence d’un cycle dans un graphe
BLANC, GRIS, NOIR = 1, 2, 3

def parcours_cy(g, couleur, s):
    """parcours en profondeur depuis le sommet s"""
    if couleur[s] == GRIS:
        return True
    if couleur[s] == NOIR:
        return False
    couleur[s] = GRIS
    for v in g.voisins(s):
        if parcours_cy(g, couleur, v):
            return True
    couleur[s] = NOIR
    return False

def cycle(g):
    couleur = {}
    for s in g.sommets():
        couleur[s] = BLANC
    for s in g.sommets():
        if parcours_cy(g, couleur, s):
            return True
    return False
Programme 42 — Parcours en largeur
def parcours_largeur(g, source):
    """parcours en largeur depuis le sommet source"""
    dist = {source: 0}
    courant = {source}
    suivant = set()
    while len(courant) > 0:
        s = courant.pop()
    for v in g.voisins(s):
        if v not in dist:
            suivant.add(v)
    dist[v] = dist[s] + 1
    if len(courant) == 0:
        courant, suivant = suivant, set()
    return dist

def distance(g, u, v):
    """distance de u à v (et None si pas de chemin)"""
    dist = parcours_largeur(g, u)
    return dist[v] if v in dist else None
Exercice 104 Dérouler à la main le parcours en profondeur sur le graphe suivant
pour différentes valeurs du sommet de départ. Donner à chaque fois la valeur finale de l’ensemble vus, c’est-à-dire l’ensemble des sommets atteints par le parcours.
Correction :
Exercice 105 Dérouler à la main le parcours en largeur sur le graphe suivant
pour différentes valeurs du sommet de départ. Donner à chaque fois la valeur finale du dictionnaire dist, c’est-à-dire la distance à la source de chaque sommet atteint par le parcours.
Correction :
Exercice 106 On peut se servir d’un parcours en profondeur pour déterminer si un graphe non orienté est connexe, c’est-à-dire si tous ses sommets sont reliés entre eux par des chemins. Pour cela, il suffit de faire un parcours en profondeur à partir d’un sommet quelconque, puis de vérifier que tous les sommets ont été atteints par ce parcours. Écrire une fonction est_connexe() qui réalise cet algorithme. On pourra se servir de la méthode sommets() de la classe Graphe et de la fonction parcours du programme Parcours en profondeur.
Correction : On suit l’algorithme proposé, en faisant uniquement attention au cas pathologique d’un graphe qui ne contiendrait aucun sommet.
def est_connexe(g):
    """le graphe est-il connexe ?
    (uniquement pour un graphe non orienté)"""
    ts = g.sommets()
    if len(ts) == 0:
        return True
    s = ts.pop()
    vus = set()
    parcours(g, vus, s)
    for s in ts:
        if s not in vus:
            return False
    return True
Exercice 107 Dans cet exercice, on se propose d’utiliser le parcours en profondeur pour construire un chemin entre deux sommets, lorsque c’est possible. On le fait avec deux fonctions, comme dans le programme Parcours en profondeur.
def parcours_ch(g, vus, org, s):
« » »parcours depuis le sommet s, en venant de org » » »
…
def chemin(g, u, v):
« » »un chemin de u à v, le cas échéant, None sinon » » »
…
L’idée est que l’attribut vus n’est plus un ensemble mais un dictionnaire, qui associe à chaque sommet visité le sommet qui a permis de l’atteindre pendant le parcours en profondeur. La fonction parcours_ch prend un argument supplémentaire, org (pour origine), qui est justement le sommet qui a permis d’atteindre s, en empruntant l’arc org → s. Écrire le code de la fonction parcours_ch ; il est très semblable à celui de la fonction parcours du programme 39. Écrire ensuite le code de la fonction chemin qui renvoie un chemin entre les sommets u et v, le cas échéant, et None s’il n’existe pas de chemin entre ces deux sommets. Pour cela, lancer un parcours en profondeur à partir du sommet u, en donnant à org la valeur None, puis, si le sommet v a été atteint, construire le chemin dans un tableau en« remontant » le dictionnaire vus de v jusqu’à u.
Correction : Pour parcours_ch, l’ajout dans un ensemble devient
un ajout dans un dictionnaire.
def parcours_ch(g, vus, org, s):
    """parcours depuis le sommet s, en venant de org"""
    if s not in vus:
        vus[s] = org
        for v in g.voisins(s):
            parcours_ch(g, vus, s, v)
Pour chemin, on prend soin de tester si v a été atteint par le parcours. Dans le cas contraire, on renvoie None. Sinon, on construit le chemin avec une boucle while.
def chemin(g, u, v):
    """un chemin de u à v, le cas échéant, None sinon"""
    vus = {}
    parcours_ch(g, vus, None, u)
    if v not in vus:
        return None
    ch = []
    s = v
    while s is not None:
        ch.append(s)
        s = vus[s]
    ch.reverse()
    return ch
De fait, le chemin est construit à l’envers. On prend soin de le renverser avec la méthode reverse avant de le renvoyer.
Exercice 108 Dans cet exercice, on se propose d’utiliser le parcours en largeur pour construire un chemin de longueur minimale entre deux sommets. On le fait avec deux fonctions, comme dans le programme Parcours en largeur.
def parcours_largeur_ch(g, source):
« » »parcours depuis le sommet source » » »
…
def chemin(g, u, v):
« » »un chemin de u à v, le cas échéant, None sinon » » »
…
L’idée est qu’un dictionnaire vus remplace le dictionnaire dist. Ce dictionnaire vus associe à chaque sommet visité le sommet qui a permis de l’atteindre pendant le parcours en largeur. Écrire le code de la fonction parcours_largeur_ch ; il est très semblable à celui de la fonction parcours_largeur du programme 42. Pour le sommet source, on lui associe la valeur None dans le dictionnaire vus. Écrire ensuite le code de la fonction chemin qui renvoie un chemin réalisant la distance entre les sommets u et v, le cas échéant, et None s’il n’existe pas de chemin entre ces deux sommets. Pour cela, lancer un parcours en largeur à partir du sommet u puis, si le sommet v a été atteint, construire le chemin dans un tableau en« remontant » le dictionnaire vus de v jusqu’à u.
Correction : On garde la structure du programme 42, le dictionnaire vus prenant la place du dictionnaire dist.
def parcours_largeur_ch(g, source):
    """parcours depuis le sommet source"""
    vus = {source: None}
    courant = {source}
    suivant = set()
    while len(courant) > 0:
        s = courant.pop()
        for v in g.voisins(s):
            if v not in vus:
                suivant.add(v)
                vus[v] = s
        if len(courant) == 0:
                courant, suivant = suivant, set()
    return vus
La seconde partie, à savoir la reconstruction du chemin, n’est pas différente de celle effectuée dans l’exercice précédent pour un parcours en profondeur.
def chemin(g, u, v):
    """un chemin de u à v, le cas échéant, None sinon"""
    vus = parcours_largeur_ch(g, u)
    if v not in vus:
        return None
    ch = []
    s = v
    while s is not None:
        ch.append(s)
        s = vus[s]
    ch.reverse()
    return ch
Exercice 109 Les nœuds d’un arbre binaire peuvent être vus comme les sommets d’un graphe non orienté. En particulier, on peut donc parcourir largeur les nœuds d’un arbre avec un parcours en profondeur ou en largeur. Pour le parcours en profondeur, il s’agit d’un parcours que nous avons déjà présenté, à savoir le parcours préfixe . Dans cet exercice, on se propose de parcourir les nœuds d’un arbre binaire avec un parcours en largeur.
Écrire une fonction largeur(a) qui reçoit un arbre binaire a en argument et imprime les valeurs de ses différents nœuds dans un ordre donné par un parcours en largeur, c’est-à-dire la valeur contenue dans la racine, puis les valeurs contenues dans les nœuds immédiatement en-dessous (profondeur 1), puis celles contenues dans les nœuds encore en-dessous (profondeur 2), etc.
Adapter pour cela le code du programme Parcours en largeur.
Correction
La subtilité consiste ici à correctement traiter les arbres vides. On a le choix de le faire avant ou après l’insertion dans les ensembles.
On choisit ici de le faire après, ce qui évite de faire un cas particulier pour un arbre qui serait intégralement vide.
def largeur(a):
    courant = []
    suivant = []
    courant.append(a)
    while len(courant) > 0:
        n = courant.pop()
        if n is None:
            continue
        print(n.valeur)
        suivant.append(n.gauche)
        suivant.append(n.droit)
        if len(courant) == 0:
            courant, suivant = suivant, []
pour la suite on utilisera une nouvelle version de ce qui a été fait sur les liste chainée. Celle ci est décomposée en deux classes : Maillons() et ListeC().
On pourra ranger tout ça dans un fichier nommé listes_chainees.py
class Maillon():
    def __init__(self, data = None):
        self.data = data
        self.suiv = None # adresse (en Python, on pointe directement vers un Maillon)

    def __repr__(self):
        t = str(self.data)
        if self.suiv is not None:
            return t + "→"
        return t + "x"


class ListeC():
    def __init__(self):
        self.tete = None # adresse (en Python, on pointe directement vers un Maillon)

    def __repr__(self):
        m = self.tete
        l = []
        while m is not None:
            l.append(str(m))
            m = m.suiv
        return "\n".join(l)

    def est_vide(self):
        """ Renvoie True si la liste est vide"""
        return self.tete is None

    def taille(self):
        """ Renvoie le nombre de maillons de la liste"""
        m = self.tete
        l = 0
        while m is not None:
            l += 1
            m = m.suiv
        return l

    def get_dernier(self):
        """Renvoie le der Maillon de la liste IndexError si liste est vide"""
        if self.est_vide():
            raise IndexError("listeC index out of range")
        m = self.tete
        while m.suiv is not None:
            m = m.suiv
        return m

    def ajouter_fin(self, v):
        """ Ajoute un élément à la fin de la liste chaînée"""
        nM = Maillon(v)
        if self.est_vide():
            self.tete = nM
        else:
            dm = self.get_dernier()
            dm.suiv = nM

    def ajouter_debut(self, v):
        """ Ajoute un élément au début de la liste chaînée"""
        nM = Maillon(v)
        if self.est_vide():
            self.tete = nM
        else:
            nM.suiv = self.tete
            self.tete = nM

    def supprimer_debut(self):
        """ Supprime et renvoie le premier élément de la liste chaînée
        IndexError si la liste est vide"""
        if self.tete is not None:
            m = self.tete
            self.tete = self.tete.suiv
            return m.data
        else:
            raise IndexError("listeC index out of range")

    def supprimer_fin(self):
        """ Supprime et renvoie le dernier élément de la liste chaînée
        IndexError si la liste est vide"""
        if self.est_vide():
            raise IndexError("listeC index out of range")
        m = self.tete
        if m.suiv is None: # 1 seul élément
            self.tete = None
            return m.data
        a = None # avant dernier
        while m.suiv is not None:
            a = m
            m = m.suiv
            a.suiv = None
        return m.data

M1,M2,M3=Maillon(4),Maillon(5),Maillon(7)
M4,M5,M6=Maillon(8),Maillon(-6),Maillon(-13)
M4.suiv=M5
M5.suiv=M6
liste1=ListeC()
liste1.ajouter_fin(M1)
liste1.ajouter_fin(M2)
liste1.ajouter_fin(M3)
print(repr(liste1))
print(repr(M1))
print(repr(M4))
print(repr(M6))
Définir en Python une classe Pile en utilisant une liste chaînée (objet de type ListeC du module listes_chainees ) comme conteneur de données.
À l’aide de seulement 3 méthodes de la classe ListeC , réaliser l’interface complète de cette pile (méthodes est_vide, empiler, et depiler).
À l’aide uniquement des 3 méthodes de l’interface de Pile , réaliser une méthode de représentation (repr). On pourra utiliser les caractères unicode de « boite » suivants : « ─ » , « └ » , « ┘ » et « │ » Avec un Tableau
Définir en Python une classe Pile en utilisant une liste Python comme conteneur de données. À l’aide de seulement 2 méthodes et une fonction, réaliser l’interface complète de cette pile.
from listes_chainees import *


class Pile:
    def __init__(self):
        self.__l = [] # attribut privé : on ne doit utiliser que l'interface élémentaire
        # Pour internationaliser les méthodes :
        self.pop = self.depiler
        self.push = self.empiler
        self.is_empty = self.est_vide

    def __repr__(self):
        l = []
        p = Pile()
        m = 0
        while not self.est_vide():
            c = self.depiler()
            l.append(str(c))
            p.empiler(c)
            m = max(m, len(str(c)))
        # on reconstruit la Pile d'origine
        while not p.est_vide():
            self.empiler(p.depiler())
        # Pour afficher une bordure :
        for i in range(len(l)):
            l[i] = "│" + l[i].ljust(m) +"│"
        return "\n".join(l) + "\n└"+ m*"─" + "┘"

    def est_vide(self):
        return len(self.__l) == 0

    def depiler(self):
        return self.__l.pop()

    def empiler(self, n):
        self.__l.append(n)
en décembre 2025 alors qu’avec la promo de T NSI on a essayé de créer une classe Maillon pour gérer les listes chainées on a rencontré un paquet de petites déconvenues. En voulant aller trop vite on (je) ne s’est pas posé toutes les questions nécessaires pour progressivement toutes les fonctions sur des bases solides.
Avant de se lancer il faut toujours se demander comment on va gérer les cas limites. Par exemple :
quel est l’élément neutre ? Comment va-t-on le gérer ?
si je veux retirer le premier élément à une chaine, que va-t-il se passer quand notre paramètre est une chaine ne contenant qu’un seul maillon ? si une chaine de ce type n’est pas l’élément neutre, alors que va-t-il se passer quand on va tenter d’appliquer la fonction retirer à l’élément neutre ?
Quand les consignes ne sont pas hyper claires, le programmeur arrive avec son imagination et ses habitudes et va avoir tendance à intérpréter la consigne à sa sauce, et à progressivement s’éloigner de la vision directrice de l’exercice telle qu’elle était envisagée par le client / concepteur de l’exercice. Dans le cadre d’exercices au niveau terminale à faire à la maison , en classe et en évaluation. Le professeur joue le rôle du client et c’est à lui d’être le plus clair possible quant à ses attentes, il doit s’assurer que ce qui est évident pour lui, l’est aussi pour les élèves. Il doit donc généralement se montrer le plus explicite possible.
En décembre 2025, voulant donner une chance aux élèves de pouvoir se confronter aux difficultés de la création d’une classe faite pour gérer les liste chainées, j’ai voulu proposer une alternative à la proposition de mon site. En surfant sur le web j’ai trouvé le site d’un collègue et décidé d’utiliser sa trame d’un collègue, sans me rendre compte qu’on pensait pas du tout de la même manière. Sans doute largement étoffées à l’oral ses consignes écrites étaient trop succinctes, et je me suis fourré dans bien des impasses et des différences irréconciliables avec l’esprit de l’exercice tel qu’il l’envisageait.
class Maillon :
    def __init__(self,v=None):
        self.val = v
        self.suiv = None

    def est_vide(self):
        """renvoie True si la liste chainée définie par le maillon de tête self est vide"""
la documentation de la méthode est_vide() gagnerait à être plus claire, surtout que beaucoup de choses vont prendre appuis sur la convention implicite qui en découle.
Au début j’avais adopté la convention qui me semblait la plus logique : une liste est vide si le maillon est vide, c’est à dire que non seulement il ne pointe vers rien mais qu’en plus sa valeur est elle aussi None. Ce n’était pas l’avis du concepteur original de l’exercice donc j’ai fait demandé aux élèves d’adopter sa convention : tout maillon non enchainé est considéré comme vide, autrement dit M est vide si M.suiv is None.
Après réflexion je n’aurai jamais dû adopter la convention de mon collègue. Même si elle peut faciliter les choses par endroit elle ne me convient pas.
cherchez de quoi compléter la méthode.
une fois que ça sera fait vous pourrez compléter aussi les autres méthodes et fonctions :
 def tailleListe(self):
        """renvoyer le nombre de Maillon de la liste"""

def get_maillon_indice(M,i):
    """renvoie le Maillon d'indice i dans la liste de tête M
    vu qu'on copie les listes habituelles, le premier indice sera 0"""


def affiche(M):
    """affiche le contenu de la liste M sous la forme [val1,val2,val3...]
    en cas de liste chainée vide on affichera []"""

# vérifications :

M1=Maillon(4)
M2=Maillon(5)
M3=Maillon(7)
M4=Maillon(None)
M1.suiv=M2
M2.suiv=M3
affiche(M1) #affichera [4,5,7]
affiche(M4) #affichera []
assert M1.est_vide() == False
assert M4.est_vide() == True
remarque : ici affiche est une fonction, on pourrait aussi la proposer sous la forme de méthode.
Corrections
class Maillon :
    def __init__(self,v=None):
        self.val = v
        self.suiv = None

    def est_vide(self):
        """renvoie True si la liste chainée
        définie par le maillon de tête self est vide"""
        return self.val is None
            # complexité O(1)

    def tailleListe(self):
        """renvoyer le nombre de Maillon de la liste"""
        liste = self
        if liste.est_vide() : return 0
        compteur = 1
        while not liste.suiv is None:
            compteur+=1
            liste = liste.suiv
        return compteur

def get_maillon_indice(M,i):
    """renvoie le Maillon d'indice i dans la liste de tête M"""
    if i> M.tailleListe() - 1 : raise IndexError("indice invalide")
    j=0
    maillonTemp = M
    while j < i :
        j+=1
        maillonTemp=maillonTemp.suiv
    return maillonTemp

def affiche(M):
    """affiche le contenu de la liste M sous la forme [val1,val2,val3...]
    en cas ou M est vide on affichera []"""
    j=0
    if M.val is None :
        print("[]")
        return
    taille = M.tailleListe()
    maillonTemp = M
    affichage="["
    while j < taille :
        affichage=affichage+str(maillonTemp.val)+","
        j+=1
        maillonTemp=maillonTemp.suiv
    print(affichage[:len(affichage)-1]+"]")


M1=Maillon(4)
M2=Maillon(5)
M3=Maillon(7)
M4=Maillon(None)
M1.suiv=M2
M2.suiv=M3
affiche(M1) #affichera [4,5,7]
affiche(M4) #affichera []
assert M1.est_vide() == False
assert M4.est_vide() == True
si on a envie d’avoir afficher en tant que méthode et non fonction , dans le code il faudra écrire à l’intérieur de la classe Maillon, en faisant attention à l’indentation :
    def affiche(self):
        """affiche le contenu de la liste sous la forme [val1,val2,val3...]
        en cas où la liste est vide on affichera []"""
        j=0
        M = self
        if M.val is None :
            print("[]")
            return
        taille = M.tailleListe()
        maillonTemp = M
        affichage="["
        while j < taille :
            affichage=affichage+str(maillonTemp.val)+","
            j+=1
            maillonTemp=maillonTemp.suiv
        print(affichage[:len(affichage)-1]+"]")
Toutefois on ne va pas utiliser cette version. Si on veut créer une méthode pour représenter un objet on utilisera plutôt une s’appelant __rep__ .
on va maintenant créer d’autres fonctions :
def ajouter_debut(M,nM):
    """ajouter le maillon nM en tête de la liste de tête M"""

def ajouter_fin(M,nM):
    """ajouter le maillon nM en fin de la liste de tête M"""

def ajouter_apres(M0,nM) :
    """inserer nM juste après M0 et le reste est décalé"""

def supprimer_debut(M):
    """supprime le 1er maillon de la liste M et le renvoie"""

def supprimer_fin(M):
    """supprime le dernier maillon de la liste M et le renvoie"""

M1,M2,M3=Maillon(4),Maillon(5),Maillon(7)
M4,M5,M6=Maillon(8),Maillon(-6),Maillon(-13)
M1.suiv=M2
M2.suiv=M3
affiche(M1) #affichera [4,5,7]
ajouter_debut(M1,M4)
affiche(M1) #affichera [4,5,7]
affiche(M4) #affichera [8,4,5,7]
ajouter_fin(M1,M5)
affiche(M1) #affichera [4,5,7,-6]
ajouter_apres(M2,M6)
affiche(M1) #affichera [4,5,-13,7,-6]
affiche(supprimer_debut(M1)) #affichera 4
affiche(M1) #affichera [5,-13,7,-6]
affiche(supprimer_fin(M1)) #affichera -6
affiche(M1) #affichera [5,-13,7]
correction
def ajouter_debut(M,nM):
    """ajouter le maillon nM en tête de la liste de tête M"""
    nM.suiv=M

def ajouter_fin(M,nM):
    """ajouter le maillon nM en fin de la liste de tête M"""
    m = M
    while m.suiv is not None:
        m = m.suiv
    m.suiv=nM

def ajouter_apres(M0,nM) :
    """inserer nM juste après M0 et le reste est décalé"""
    nM.suiv = M0.suiv
    M0.suiv = nM


def supprimer_debut_best(M):
    """supprime le 1er maillon de la liste M et renvoie ce maillon et la nouvelle chaine obtenue
    si la liste M ne contient qu'un seul maillon alors après execution M vaudra None"""
    temp = M.suiv #ça  sert de stockage temporaire pour la partie de M que l'on gardera
    tete = Maillon(M.val)
    if temp is not None :
        sortie= Maillon(temp.val)
        sortie.suiv = temp.suiv
    else :
        sortie = None
    return tete, sortie


def supprimer_debut(M):
    """supprime le 1er maillon de la liste M et le renvoie"""
    Maillon_tete=Maillon(M.val) #je récupère la tête qui sera renvoyée
    if M.suiv is not None :
        Mtemp=Maillon(M.suiv.val)
        Mtemp.suiv=M.suiv.suiv
        M.val,M.suiv = Mtemp.val, Mtemp.suiv #copie de Mtemp vers M
    else :
        M.val,M.suiv = None,None
    return Maillon_tete

def supprimer_fin(M):
    """supprime le dernier maillon de la liste M et le renvoie"""
    if M.tailleListe() ==0 : raise IndexError("rien à supprimer")
    if M.tailleListe() == 1 :
        Maillon_queue = Maillon(M.val)
        M.val,M.suiv = None,None
        return Maillon_queue
    m = M
    while m.suiv.suiv is not None:
        m = m.suiv
    Maillon_queue=m.suiv
    m.suiv=None
    return Maillon_queue
XXXXXXXXXXXXXXXXXXXXXX
création d’une fonction pour renverser une liste chainée
def renverser(M)  :
    """renvois le renversement de la liste chaînée de maillon de tête M"""


M1,M2,M3=Maillon(4),Maillon(5),Maillon(7)
M4,M5,M6=Maillon(8),Maillon(-6),Maillon(-13)
M1.suiv=M2
M2.suiv=M3
M3.suiv=M4
affiche(M1) #affichera [4,5,7,8]
affiche(renverser(M1)) #affichera [8,7,5,4]
suite version qui ne marche pas
def renverser(M)  :
    """renvois le renversement de la liste chaînée de maillon de tête M"""
    renverse = Maillon(M.val)
    temp = Maillon(0)
    next=M.suiv
    while not next is None :
        temp.val = next.val
        temp.suiv = renverse
        renverse = temp
        next = next.suiv
    return renverse
à votre avis quel est le problème ???
indice : injecter dans la boucle while juste avant la dernière ligne la commande :
print(id(temp))
ça permet de voir que l’objet temp est bidouillé encore et encore mais ça reste du début à la fin le même objet… et qu’à force on finit par le définir en fonction de lui même, un autoréférencement très problématique qui génère le crash (boucle infinie observée)
version qui marche
def renverser(M)  :
    """renvois le renversement de la liste chaînée de maillon de tête M"""
    renverse = Maillon(M.val)
    next=M.suiv
    while not next is None :
        temp=Maillon(next.val)
        temp.suiv = renverse
        renverse = temp
        print(id(temp)) #ligne qui sera enlevé une fois le problème d'auto référencement bien compris
        next = next.suiv
    return renverse
non seulement ça marche mais en plus on voit bien , qu’à chaque tour de boucle on a un objet temp différent. Le nom est le même mais c’est écrasé encore et encore.
concaténation
créer la fonction suivante :
def concatener(M1, M2) :
    """retourne une nouvelle liste, résultat de la concaténation des listes de maillons de tête M1  et M2."""

M1,M2,M3=Maillon(4),Maillon(5),Maillon(7)
M4,M5,M6=Maillon(8),Maillon(-6),Maillon(-13)
M1.suiv=M2
M2.suiv=M3
M4.suiv=M5
M5.suiv=M6
affiche(M1) #affichera [4,5,7]
affiche(M4) #affichera [8,-6,-13]
affiche(concatener(M1, M4)) #affichera [4,5,7,8,-6,-13]
Remarque : concatener(M1, M2) ne modifiera aucune des deux listes chainées passées en paramètres mais renverra leur concaténation.
Solution :
def concatener(M1, M2) :
    """retourne une nouvelle liste, résultat de la concaténation des listes de maillons de tête M1  et M2."""
    M = Maillon(M1.val)
    M.suiv = M1.suiv
    ajouter_fin(M,M2)
    return M
Bonus
voici une alternative à la fonction afficher :
def __repr__(self):
    if self.suiv is None:
        return str(self.val)
    return str(self.val) + " -> " + repr(self.suiv)
C’est une méthode classique, un incontournable de la programmation objet. Si on veut respecter le mécanisme standard de Python (autrement dit le « protocole ») Elle s’appellera non pas comme une méthode mais comme une fonction:
La fonction implémente la relation rn=max1≤i≤n(pi+rn−i). Le terme manquant dans la boucle est la valeur récursive du reste de la barre : revenu_barre(n-i).
Python
def revenu_barre(n):
   prix = [0, 1, 5, 8, 9, 10, 17, 17, 20, 24, 30] # Indice 0 inutilisé
   if n == 0:
        return 0 # Cas de base: revenu pour une barre de longueur 0 est 0

   r = float('-inf')
   for i in range(1, n + 1):
       # r = max(r, prix[longueur_du_premier_morceau] + revenu_max_du_reste)
       r = max(r, prix[i] + revenu_barre(n - i))
   return r
4. Application des Tarifs Initiaux :
En exécutant la fonction revenu_barre(n) avec les tarifs initiaux :
r5=13€ (Découpe : 2+3 ou 3+2)
r6=17€ (Découpe : 6 entier)
r7=18€ (Découpe : 1+6 ou 6+1)
r8=22€ (Découpe : 2+6 ou 6+2)
r9=25€ (Découpe : 1+8 ou 8+1)
r10=30€ (Découpe : 10 entier)
5. Changement de Tarifs :
Le tableau prix doit être mis à jour. Nouvelle liste des prix : prix = [0, 1, 6, 9, 11, 12, 19, 20, 23, 24, 26]
En réexécutant la fonction avec les nouveaux prix :
r5=15€ (Découpe : 2+3)
r6=19€ (Découpe : 6 entier)
r7=21€ (Découpe : 1+6 ou 6+1)
r8=25€ (Découpe : 2+6 ou 6+2)
r9=28€ (Découpe : 3+6 ou 6+3)
r10=31€ (Découpe : 2+8 ou 8+2)
Partie II : Optimisation par Programmation Dynamique
6. Approche Descendante (Mémorisation) :
On utilise un tableau mem pour stocker les résultats et éviter de recalculer rk.
Python
def revenu_barre_dyn_desc(n):
    prix = [0, 1, 6, 9, 11, 12, 19, 20, 23, 24, 26]
    mem = [-1] * (n + 1) # -1 indique que le revenu n'a pas encore été calculé

    def r_mem(k):
        if k == 0:
            return 0

        # 1. Vérification : Si déjà calculé, retourner le résultat mémorisé
        if mem[k] != -1:
            return mem[k]

        # 2. Calcul : Sinon, calculer le revenu maximal
        r_max = float('-inf')
        for i in range(1, k + 1):
            # Utiliser r_mem(k - i) pour l'appel récursif (mémorisé)
            r_max = max(r_max, prix[i] + r_mem(k - i))

        # 3. Mémorisation : Stocker le résultat avant de le retourner
        mem[k] = r_max
        return r_max

    return r_mem(n)
7. Approche Ascendante (Itérative) :
On construit le tableau des revenus maximaux tab de bas en haut, de r1 à rn.
Python
def revenu_barre_dyn_asc(n):
    prix = [0, 1, 6, 9, 11, 12, 19, 20, 23, 24, 26]
    tab = [0] * (n + 1) # tab[i] stockera le revenu maximal ri
    # tab[0] est déjà à 0 (r0 = 0)

    # On itère de la longueur m=1 à m=n
    for m in range(1, n + 1):
        r_max = float('-inf')
        # On calcule le revenu maximal pour la longueur m
        for i in range(1, m + 1):
            # Calcul r_max = max(pi + r_m-i)
            # tab[m-i] contient le revenu r_m-i déjà calculé
            r_max = max(r_max, prix[i] + tab[m - i])

        tab[m] = r_max

    return tab[n]
Corrigé de l’Exercice 2 : Score Maximal dans une Pyramide de Nombres
Pyramides utilisées :
ex1 = [[4],[6,2],[3,5,7],[5,1,6,2],[4,7,3,5,2]]
ex2 = [[3],[1,2],[4,5,9],[3,6,2,1]]
Partie I : Représentation et Fonctions de Base
1. Dessiner la pyramide ex2 :
      [3]
     [1, 2]
    [4, 5, 9]
   [3, 6, 2, 1]
2. Dessiner le chemin ch2 = [0,1,2,2] dans ex2 :
Niveau
Indice
Nombre
0
0
3
1
1
2
2
2
9
3
2
2
Exporter vers Sheets
Le chemin est : 3→2→9→2.
3. Calculer le score de ch2 :
3+2+9+2=16
4. Fonction est_chemin(ch, p) :
Python
def est_chemin(ch, p):
    # Règle 1: La longueur doit correspondre au nombre de niveaux
    if len(ch) != len(p):
        return False

    # Règle 2: Doit commencer par 0
    if ch[0] != 0:
        return False

    # Règle 3: Vérification du déplacement
    for i in range(len(ch) - 1):
        a = ch[i]
        b = ch[i+1]

        # Le nouvel indice (b) doit être a ou a + 1
        if not (b == a or b == a + 1):
            return False

    # Si toutes les règles sont respectées
    return True

# Tests :
# est_chemin([0,1,2,2], ex2) -> True
# est_chemin([0, 0, 0, 2], ex2) -> False (problème à l'étape 3, 0 -> 2)
5. Fonction score(ch, p) :
Python
def score(ch, p):
    s = 0
    # Parcourt chaque niveau (i) de la pyramide et l'indice (j) du chemin
    for i in range(len(p)):
        j = ch[i]
        s += p[i][j]
    return s

# Test :
# score([0,1,1,1,2], ex1) -> 4 + 2 + 5 + 1 + 3 = 15
Partie II : Programmation Dynamique pour l’Optimisation
6. Fonction calcule_score_max(p) (Récursive Naïve) :
On utilise la relation récursive score_max(i,j)=p[i][j]+max(score_max(i+1,j),score_max(i+1,j+1)).
Python
def calcule_score_max(p, i=0, j=0):
    # Cas de base (dernier niveau)
    if i == len(p) - 1:
        return p[i][j]

    # Cas récursif: valeur du niveau courant + max des scores des deux sous-pyramides
    gauche = calcule_score_max(p, i + 1, j)
    droite = calcule_score_max(p, i + 1, j + 1)

    return p[i][j] + max(gauche, droite)

# Le score maximal est obtenu par calcule_score_max(ex1)
7. Fonction pyramide_nulle(n) :
La pyramide doit avoir n niveaux, avec i+1 éléments au niveau i.
Python
def pyramide_nulle(n):
    pyramide = []
    for i in range(n):
        # Chaque niveau i a une taille de i + 1
        pyramide.append([0] * (i + 1))
    return pyramide

# Exemple: pyramide_nulle(4) -> [[0],[0,0],[0,0,0],[0,0,0,0]]
8. Fonction prog_dyn(p) (Ascendante) :
On remplit la pyramide des scores s de bas en haut (du dernier niveau au sommet).
Python
def prog_dyn(p):
    n = len(p)
    if n == 0:
        return 0

    # Création de la pyramide des scores maximaux (s)
    # L'approche ascendante utilise souvent un tableau de la taille des données d'entrée.
    # Pour simplifier, on peut initialiser s avec la structure de p (ou une copie)
    s = [list(niveau) for niveau in p]

    # On commence par l'avant-dernier niveau et on remonte jusqu'au sommet (niveau 0)
    for i in range(n - 2, -1, -1):
        # Pour chaque élément (j) du niveau i
        for j in range(len(s[i])):

            # Application de la relation de récurrence (score_max)
            # p[i][j] + max(score_max(i+1, j), score_max(i+1, j+1))

            # Les valeurs score_max(i+1, ...) sont déjà calculées au niveau i+1 de s.
            max_suivants = max(s[i+1][j], s[i+1][j+1])

            # Mise à jour du score maximal pour l'élément (i, j)
            s[i][j] = p[i][j] + max_suivants

    # Le score maximal pour la pyramide entière est au sommet
    return s[0][0]

# Test : prog_dyn(ex1) -> 4 + max(6, 2) + ... -> 23
9. Ordre de grandeur du coût de prog_dyn(p) :
La fonction prog_dyn(p) effectue deux boucles imbriquées :
La boucle extérieure parcourt les niveaux, de i=n−2 à 0 (soit ≈n niveaux).
La boucle intérieure parcourt les éléments j à chaque niveau. Au niveau i, il y a i+1 éléments.
Le nombre total d’opérations est proportionnel à la somme du nombre d’éléments dans la pyramide :
Le coût est donc dominé par n2. L’ordre de grandeur du coût est O(n2) (où n est le nombre de niveaux), ce qui est bien plus performant que l’approche récursive naïve en O(2n).
exercices
Exercice 1 Appels Redondants
Analyse des Appels Récursifs : L’exécution de rendu_monnaie([1, 2], 3) génère la séquence d’appels suivante :
rendu_monnaie(..., 3)
Appelle rendu_monnaie(..., 3 - 1 = 2)
Appelle rendu_monnaie(..., 3 - 2 = 1)
rendu_monnaie(..., 2)
Appelle rendu_monnaie(..., 2 - 1 = 1)
Appelle rendu_monnaie(..., 2 - 2 = 0)
rendu_monnaie(..., 1)
Appelle rendu_monnaie(..., 1 - 1 = 0)
rendu_monnaie(..., 0) → Retourne 0
rendu_monnaie(..., 1) (Appelé depuis s=2)
Appelle rendu_monnaie(..., 1 - 1 = 0)
rendu_monnaie(..., 0) → Retourne 0
rendu_monnaie(..., 0) → Retourne 0
Conclusion sur la Redondance : Sur les 7 appels totaux (en comptant le premier), on constate que :
Le sous-problème pour la somme s=1 a été calculé 2 fois.
Le sous-problème pour la somme s=0 a été calculé 3 fois.
Ceci illustre le principe des sous-problèmes qui se chevauchent, caractéristique des problèmes résolus par Programmation Dynamique.
.
Corrigé 2 : Calcul du Tableau nb
Système de pièces : P={1,6,10}. Somme finale : S=12. Le tableau nb a une taille S+1=13 (indices 0 à 12). nb[0]=0.
n
Initialisation
p=1 (1 + nb[n−1])
p=6 (1 + nb[n−6])
p=10 (1 + nb[n−10])
nb[n] Final
0
0
–
–
–
0
1
1
min(1,1+0)=1
–
–
1
2
2
min(2,1+1)=2
–
–
2
3
3
min(3,1+2)=3
–
–
3
4
4
min(4,1+3)=4
–
–
4
5
5
min(5,1+4)=5
–
–
5
6
6
min(6,1+5)=6
min(6,1+0)=1
–
1
7
7
min(7,1+1)=2
min(2,1+1)=2
–
2
8
8
min(8,1+2)=3
min(3,1+2)=3
–
3
9
9
min(9,1+3)=4
min(4,1+3)=4
–
4
10
10
min(10,1+4)=5
min(5,1+4)=5
min(5,1+0)=1
1
11
11
min(11,1+1)=2
min(2,1+5)=2
min(2,1+1)=2
2
12
12
min(12,1+2)=3
min(3,1+6)=3
min(3,1+2)=2
2
Exporter vers Sheets
Tableau Final nb :
[0,1,2,3,4,5,1,2,3,4,1,2,2]
Le résultat final est nb[12]=2 (par exemple, 6+6 ou 10+2).
.
Corrigé 3 : Code Python avec Solution
Pour suivre la solution optimale, nous ajoutons un deuxième tableau, sol, qui mémorise la liste des pièces pour chaque somme n. Lorsque nous trouvons un meilleur score (1 + nb[n - p] < nb[n]), nous mettons à jour la solution en copiant la solution du sous-problème (sol[n - p]) et en lui ajoutant la pièce p qui a permis cette amélioration.
Python
def rendu_monnaie_solution(pieces, s):
    """
    Renvoie la liste minimale de pièces pour faire la somme s
    avec le système 'pieces' (Programmation Dynamique).
    """
    # Initialisation au pire cas (n pièces de 1)
    nb = [n for n in range(s + 1)]          # Nombre minimal de pièces
    sol = [[1] * n for n in range(s + 1)] # Liste des pièces utilisées pour chaque somme
    sol[0] = []

    for n in range(1, s + 1):
        for p in pieces:
            if p <= n:
                # Si prendre la pièce p mène à un meilleur nombre total de pièces
                if 1 + nb[n - p] < nb[n]:
                    nb[n] = 1 + nb[n - p]

                    # Mise à jour de la solution :
                    # Prendre la solution optimale pour le reste (n-p) et ajouter la pièce p
                    sol[n] = sol[n - p].copy()
                    sol[n].append(p)

    # Retourne la solution optimale pour la somme s
    return sol[s]
Corrigé 4 : Code Python pour Fibonacci
La solution utilise un tableau f pour stocker toutes les valeurs F0,F1,…,Fn et les calculer de manière itérative, de bas en haut.
Python
def fibonacci(n):
    if n < 0:
        raise ValueError("n doit être positif")
    if n == 0:
        return 0

    # Création du tableau de mémorisation F[0] à F[n]
    f = [0] * (n + 1)

    # Initialisation des cas de base
    # f[0] = 0 (déjà fait par l'initialisation)
    f[1] = 1

    # Calcul itératif de F[2] jusqu'à F[n]
    for i in range(2, n + 1):
        # f[i] = f[i-2] + f[i-1] (Approche ascendante)
        f[i] = f[i - 2] + f[i - 1]

    return f[n]
Corrigé 5 : Tableau des Scores d’Alignement
Mots : s1= »CHAT » (n1=4) et s2= »CAT » (n2=3).
sc
−
C
A
T
−
0
-1
-2
-3
C
-1
1
0
-1
H
-2
0
0
0
A
-3
-1
1
0
T
-4
-2
0
2
Calculs clés :
sc[1][1] (C vs C) : max(−1+sc[0][1],−1+sc[1][0],1+sc[0][0])max(−1−1,−1−1,1+0)=max(−2,−2,1)=1
sc[2][2] (H vs A) : max(−1+sc[1][2],−1+sc[2][1],−1+sc[1][1])max(−1+0,−1+0,−1+1)=max(−1,−1,0)=0
sc[4][3] (T vs T) : max(−1+sc[3][3],−1+sc[4][2],1+sc[3][2])max(−1+0,−1+0,1+1)=max(−1,−1,2)=2
Le score maximal d’alignement (valeur dans la dernière case) est 2. (Un alignement optimal est : CH-AT contre C-AT, score 1−1+1+1=2).
Corrigé 6 : Alignement AAAAAAAAAA vs BBBBBBBBBB
Score Maximal : Puisque tous les caractères sont différents, il n’y a aucun match possible. Chaque paire alignée (A,B) est un mismatch avec un score de −1. Un alignement optimal sera l’un des deux suivants :
10 Mismatchs : Score 10×(−1)=−10.
Gaps : L’alignement sera au maximum 10×(−1)=−10.
Le score maximal est −10.
Forme du Tableau (sc) : Le tableau sc a une taille 11×11.
sc
−
B
B
…
B
−
0
-1
-2
…
-10
A
-1
-1
-2
…
-10
A
-2
-2
-2
…
-10
A
-3
-3
-3
…
-10
…
…
…
…
…
…
A
-10
-10
-10
…
-10
Explication de la Forme :
Bords (Ligne 0 et Colonne 0) : Remplis par les scores de gap : −i ou −j.
Intérieur : Pour chaque case sc[i][j], la valeur est max(−1+sc[i−1][j],−1+sc[i][j−1],−1+sc[i−1][j−1]).
La meilleure option est toujours de prolonger l’alignement existant ou de le commencer.
La valeur sc[i][j] est max(sc[i−1][j],sc[i][j−1],sc[i−1][j−1])−1.
La structure triangulaire de −i sur la diagonale supérieure puis −j sur la diagonale inférieure n’est pas correcte. En réalité, le score sera simplement −max(i,j), car on peut toujours aligner la partie la plus courte avec des gaps et terminer avec des mismatchs. Dans ce cas particulier, sc[i][j]=−max(i,j).
(La correction fournie dans l’énoncé original semble contenir une erreur dans sa description de la structure générale du tableau pour ce cas).
Corrigé 7 : Fonction d’Affichage Formattée
La fonction utilise la méthode de formatage {:>3} pour assurer que chaque élément (caractère ou score) occupe exactement 3 espaces, aligné à droite.
Python
def affiche(s1, s2, sc):
    """Affiche la table des scores d'alignement de manière formattée."""

    # 1. Affichage de l'en-tête de colonne (s2)
    print(" ", end="") # Espace pour l'angle supérieur gauche
    for c in s2:
        print('{:>3}'.format(c), end="")
    print() # Retour à la ligne pour le début du tableau

    # 2. Affichage des lignes (s1 et scores)
    for i in range(len(sc)): # i va de 0 à len(s1)

        # Affichage du caractère de début de ligne (s1[i-1] ou espace/tirets pour la ligne 0)
        if i > 0:
            print('{:>3}'.format(s1[i - 1]), end="")
        else:
            print(" ", end="") # Espace pour la première ligne (index 0)

        # Affichage des scores de la ligne
        for v in sc[i]:
            print('{:>3}'.format(v), end="")
        print() # Retour à la ligne pour la ligne suivante

# Exemple d'utilisation (avec les données de l'exercice 5) :
# s1 = "CHAT", s2 = "CAT", sc = [[0,-1,-2,-3],[-1,1,0,-1],[-2,0,0,0],[-3,-1,1,0],[-4,-2,0,2]]
# affiche(s1, s2, sc)
#     C  A  T
#   0 -1 -2 -3
# C -1  1  0 -1
# H -2  0  0  0
# A -3 -1  1  0
# T -4 -2  0  2
Corrigé 8 : Reconstruction de la Solution
Nous introduisons un deuxième tableau, sol, qui, pour chaque paire d’indices (i,j), stocke la meilleure séquence d’alignement trouvée jusqu’à cet état (s1[0:i],s2[0:j]).
Python
def aligne_solution(s1, s2):
    n1, n2 = len(s1), len(s2)
    sc = [[0] * (n2 + 1) for _ in range(n1 + 1)]
    # sol[i][j] stockera le couple (align_s1, align_s2) optimal jusqu'à s1[i-1], s2[j-1]
    sol = [[("", "")] * (n2 + 1) for _ in range(n1 + 1)]

    # Initialisation des bords (Gaps)
    for i in range(1, n1 + 1):
        sc[i][0] = -i
        sol[i][0] = (s1[0:i], "-" * i) # Alignement de s1[0:i] avec des gaps
    for j in range(1, n2 + 1):
        sc[0][j] = -j
        sol[0][j] = ("-" * j, s2[0:j]) # Alignement de s2[0:j] avec des gaps

    # Reste du tableau
    for i in range(1, n1 + 1):
        for j in range(1, n2 + 1):

            # Options possibles et leurs scores
            score_gap_s1 = -1 + sc[i - 1][j]           # Gap dans s2 (vertical)
            score_gap_s2 = -1 + sc[i][j - 1]           # Gap dans s1 (horizontal)

            # Match ou Mismatch
            sim_score = 1 if s1[i - 1] == s2[j - 1] else -1
            score_diag = sim_score + sc[i - 1][j - 1] # Diagonale

            # Détermination du score maximal et de la solution correspondante

            # 1. Initialisation avec le meilleur score connu (souvent un gap)
            s_max = score_gap_s1
            (x, y) = sol[i - 1][j]
            sol[i][j] = (x + s1[i - 1], y + "-") # Aligne s1[i-1] avec un gap

            # 2. Test du Gap dans s1
            if score_gap_s2 > s_max:
                s_max = score_gap_s2
                (x, y) = sol[i][j - 1]
                sol[i][j] = (x + "-", y + s2[j - 1]) # Aligne s2[j-1] avec un gap

            # 3. Test de la Diagonale (Match ou Mismatch)
            if score_diag > s_max:
                s_max = score_diag
                (x, y) = sol[i - 1][j - 1]
                sol[i][j] = (x + s1[i - 1], y + s2[j - 1]) # Aligne les deux caractères

            sc[i][j] = s_max

    # Retourne le score et le couple de chaînes alignées
    return sc[n1][n2], sol[n1][n2]
Corrigé 9 : Adaptation du Programme pour la Biologie
Représentation de la Matrice de Similarités : Le format le plus pratique est un dictionnaire imbriqué (un dictionnaire de dictionnaires), permettant un accès facile O(1) par caractère :
Modification du Programme 48 : On remplace le score fixe de −1 pour les gaps et le score conditionnel de ±1 pour la diagonale par les valeurs de gap et de la matrice sim.
Python
def aligne_custom(s1, s2, sim, gap):
    n1, n2 = len(s1), len(s2)
    sc = [[0] * (n2 + 1) for _ in range(n1 + 1)]

    # Initialisation des bords avec le coût de gap
    for i in range(1, n1 + 1):
        sc[i][0] = i * gap # -1 est remplacé par gap
    for j in range(1, n2 + 1):
        sc[0][j] = j * gap # -1 est remplacé par gap

    # Le reste
    for i in range(1, n1 + 1):
        for j in range(1, n2 + 1):

            # 1. Score de Gap dans s2 (déplacement vertical)
            score_gap_s2 = gap + sc[i - 1][j]

            # 2. Score de Gap dans s1 (déplacement horizontal)
            score_gap_s1 = gap + sc[i][j - 1]

            # 3. Score d'alignement (déplacement diagonal)
            # Utilisation de la matrice sim
            score_sim = sim[s1[i - 1]][s2[j - 1]] + sc[i - 1][j - 1]

            # Score maximal parmi les trois options
            sc[i][j] = max(score_gap_s1, score_gap_s2, score_sim)

    return sc[n1][n2]
Corrigé 10 : Dénombrement sur Grille
Ce problème est résolu par la relation de récurrence : le nombre de chemins pour atteindre une case (i,j) est la somme des chemins pour atteindre la case du dessus (i−1,j) et la case de gauche (i,j−1).
chemins(i,j)=chemins(i−1,j)+chemins(i,j−1)
Cas de base :
Le nombre de chemins pour atteindre n’importe quelle case sur la première ligne (i=0) ou la première colonne (j=0) est toujours 1.
Python
def chemins(n, m):
    """
    Calcule le nombre de chemins de (0, 0) à (n, m) sur une grille,
    avec déplacements uniquement à droite ou en bas.
    """
    # La grille aura (n+1) lignes et (m+1) colonnes
    grille = [[0] * (m + 1) for _ in range(n + 1)]

    # Initialisation des bords (Cas de base: 1 chemin pour atteindre n'importe quelle case de la bordure)
    for i in range(n + 1):
        grille[i][0] = 1
    for j in range(m + 1):
        grille[0][j] = 1

    # Remplissage de la grille par approche ascendante
    for i in range(1, n + 1):
        for j in range(1, m + 1):
            # Le nombre de chemins pour (i, j) est la somme des chemins depuis le haut et la gauche
            grille[i][j] = grille[i - 1][j] + grille[i][j - 1]

    return grille[n][m]

# Vérification : chemins(2, 2) = 6 (Comme mentionné en introduction)
Exercice 1 : Le Problème de la Coupe de Barres d’Acier (Rod Cutting)
Ce problème, inspiré du livre « Introduction to Algorithms, » vise à maximiser le revenu obtenu en coupant une barre d’acier de longueur n en morceaux plus petits.
Données tarifaires :
Longueur i (m)
1
2
3
4
5
6
7
8
9
10
Prix pi (€)
1
5
8
9
10
17
17
20
24
30
L’entreprise Sun & Steel peut vendre une barre entière ou la découper pour maximiser son revenu.
Partie I : Analyse et Récursivité Naïve
1) Exploration des possibilités pour n=4 : La barre de 4 m peut être coupée de plusieurs façons. Continuez la liste ci-dessous pour trouver toutes les combinaisons de découpes et déterminez le revenu maximum r4 possible :
Vente entière (4): 9€
Découpe en 2 morceaux (2+2): 5+5=10€
Découpe en 2 morceaux (1+3): 1+8=9€
Découpe en 3 morceaux (1+1+2): 1+1+5=7€
… Ajoutez les combinaisons manquantes (par ex. 1+1+1+1, 1+2+1, etc.)
2) Formulation de la Relation de Récurrence : Le revenu maximum rn pour une barre de longueur n peut être calculé en considérant toutes les premières coupes possibles. On coupe la barre de longueur n en un premier morceau de longueur i (vendu au prix pi) et on optimise le revenu sur le morceau restant de longueur n−i (qui rapporte rn−i).La relation de récurrence est donc : rn=max(pi+rn−i) où 1≤i≤n et r0=0 (revenu pour une barre de longueur nulle).Utilisez cette relation pour retrouver la valeur de r4 en utilisant les revenus maximaux déjà calculés : r1=1,r2=5,r3=8.
r4=max(p1+r3, p2+r2, p3+r1, p4+r0)
3) Implémentation Récursive (Naïve) : Complétez la fonction récursive ci-dessous, qui implémente directement la relation rn=max1≤i≤n(pi+rn−i).
def revenu_barre(n):
    prix = [0, 1, 5, 8, 9, 10, 17, 17, 20, 24, 30] # Indice 0 inutilisé, prix[1] = p1, etc.
    if n == 0:
        return … # Cas de base
    r = float('-inf') # Initialisation au minimum possible
    for i in range(1, n + 1):
        # i est la longueur du premier morceau coupé
        r = max(r, prix[i] + ...) # Terme récursif à ajouter
    return r
4) Application : Utilisez la fonction revenu_barre pour calculer les revenus maximaux r5,r6,r7,r8,r9 et r10.
5) Changement de Tarifs : Le nouveau tableau de prix est proposé dans le tableau proposé plus bas. Modifiez le tableau prix dans la fonction revenu_barre et recalculez les revenus maximaux rn pour n allant de 5 à 10.
Longueur i (m)
1
2
3
4
5
6
7
8
9
10
Prix pi (€)
1
6
9
11
12
19
20
23
24
26
Partie II : Optimisation par Programmation Dynamique
L’approche récursive simple entraîne de nombreux recalculs inutiles (sous-problèmes qui se chevauchent).
Pour une barre de 4 m, l’arbre de calcul montre que r1 est calculé 4 fois et r2 est calculé 2 fois. La programmation dynamique permet d’éviter cette redondance.
Approche Descendante (Mémorisation) : Écrivez une fonction revenu_barre_dyn_desc(n) qui utilise la mémorisation (un tableau mem) pour stocker et réutiliser les valeurs de ri déjà calculées, évitant ainsi les appels récursifs redondants.
Indice : La structure sera similaire à fib_mem du cours. Le tableau mem stocke ri. Avant tout appel récursif, vérifiez si mem[n] est déjà calculé.
Approche Ascendante (Itérative) : Écrivez une fonction revenu_barre_dyn_asc(n) qui utilise une méthode itérative (boucles) pour calculer ri séquentiellement, de r1 à rn, en stockant les résultats dans un tableau.
Indice : Initialisez un tableau tab de taille n+1 avec tab[0]=0. Utilisez une boucle for allant de m=1 à n pour calculer tab[m] en utilisant la relation de récurrence et les valeurs déjà présentes dans le tableau.
Exercice 2 : Score Maximal dans une Pyramide de Nombres
Ce problème consiste à trouver le chemin de score maximal en partant du sommet d’une pyramide et en descendant en choisissant, à chaque niveau, l’élément immédiatement à gauche ou à droite.
La pyramide est représentée par une liste de listes. Exemple : ex1 = [[4],[6,2],[3,5,7],[5,1,6,2],[4,7,3,5,2]]
En gris on peut lire un des chemins possibles (qui est loin d’être le plus long) son score sera : 4 + 2 + 5 + 1 + 3 = 15.
Partie I : Représentation et Fonctions de Base
Représentation : Dessinez la pyramide représentée par la liste de listes ex2 = [[3],[1,2],[4,5,9],[3,6,2,1]].
Chemins et Indices : Un chemin est représenté par la liste des indices choisis à chaque niveau. Par exemple, le chemin gris dans ex1 est ch1 = [0,1,1,1,2]. Dessinez le chemin ch2 = [0,1,2,2] dans la pyramide ex2.
Calcul du Score : Calculez le score du chemin ch2 = [0,1,2,2] dans la pyramide ex2.
Fonction de Validation : Écrivez une fonction est_chemin(ch, p) qui vérifie si une liste d’indices ch est un chemin valide dans la pyramide p. Les règles sont :
Doit commencer par 0 (ch[0] == 0).
La longueur de ch doit être égale au nombre de niveaux de p.
Chaque indice consécutif b (au niveau i+1) doit être a ou a+1 par rapport à l’indice précédent a (au niveau i).
Tests :est_chemin(ch2, ex2) doit renvoyer True. est_chemin([0, 0, 0, 2], ex2) doit renvoyer False.
Fonction de Score : Écrivez une fonction score(ch, p) qui prend un chemin valide et la pyramide, et renvoie le score total.
Test :score(ch1, ex1) doit renvoyer 15.
Partie II : Programmation Dynamique pour l’Optimisation
Le problème du chemin maximal présente une structure de sous-problèmes optimaux. Le chemin optimal de la pyramide entière est composé du sommet et du chemin optimal de l’une des deux sous-pyramides adjacentes.
Soit score_max(i,j) le score maximal possible à partir du nombre situé à l’indice j du niveau i.
Les relations sont :
Cas de base (dernier niveau) : score_max(len(p)−1,j)=p[len(p)−1][j]
Cas récursif : score_max(i,j)=p[i][j]+max(score_max(i+1,j),score_max(i+1,j+1))
Implémentation Récursive (Naïve) : Écrivez une fonction calcule_score_max(p) qui utilise directement la relation de récurrence pour trouver le score maximal score_max(0,0).
Préparation pour la PD : Écrivez une fonction pyramide_nulle(n) qui crée une structure de pyramide (liste de listes) de n niveaux, remplie de zéros. Cette pyramide servira de tableau de mémorisation.
Approche Ascendante (Programmation Dynamique) : Écrivez une fonction prog_dyn(p) qui calcule le score maximal en utilisant la programmation dynamique ascendante (du bas vers le haut).
Créez une pyramide de mémorisation s de la même taille que p.
Commencez par initialiser le dernier niveau de s avec les valeurs du dernier niveau de p.
Remontez itérativement niveau par niveau (de len(p)−2 jusqu’à 0), en appliquant la formule score_max(i,j).
Le résultat final sera s[0][0].
Analyse de Complexité : Déterminez l’ordre de grandeur du coût (complexité en temps) de la fonction prog_dyn(p) pour une pyramide à n niveaux (sachant que le nombre d’éléments au niveau i est i+1).
Exercice 1 : Analyse de la Récursivité Naïve (Rendu de Monnaie)
Objectif : Identifier l’inefficacité des algorithmes récursifs sans mémorisation.
Énoncé : Soit la fonction récursive rendu_monnaie qui calcule le nombre minimal de pièces pour une somme donnée, sans utiliser la programmation dynamique :
Python
def rendu_monnaie(pieces, s):
    """
    Renvoie le nombre minimal de pièces pour faire la somme s
    avec le système 'pieces' (approche récursive naïve).
    """
    if s == 0:
        return 0

    r = s # Initialisation au pire cas (1+1+...+1)
    for p in pieces:
        if p <= s:
            r = min(r, 1 + rendu_monnaie(pieces, s - p))
    return r
Question :Explicitez (à la main) tous les appels récursifs effectués par la fonction lorsque vous exécutez rendu_monnaie([1, 2], 3). Identifiez clairement les calculs redondants (les sous-problèmes qui sont résolus plusieurs fois).
Exercice 2 : Rendu de Monnaie par Programmation Dynamique (Ascendante)
Objectif : Comprendre le remplissage du tableau de mémorisation dans l’approche ascendante (Bottom-up).
Énoncé : Soit le programme d’approche ascendante (Programmation Dynamique) pour le rendu de monnaie :
Python
def rendu_monnaie(pieces, s):
    """
    Renvoie le nombre minimal de pièces pour faire la somme s
    avec le système 'pieces' (approche dynamique ascendante).
    """
    nb = [0] * (s + 1) # Tableau de mémorisation

    for n in range(1, s + 1):
        nb[n] = n # Initialisation au pire cas (1+1+...+1)
        for p in pieces:
            if p <= n:
                # Mise à jour: 1 + nb[n - p] est le nombre de pièces si on prend la pièce p
                nb[n] = min(nb[n], 1 + nb[n - p])
    return nb[s]
Question :Calculez à la main et présentez l’état final du tableau nb lorsque l’on exécute rendu_monnaie([1, 6, 10], 12).
Exercice 3 : Rendu de Monnaie avec Solution Optimale
Objectif : Étendre l’approche dynamique pour tracer et reconstruire la solution (les pièces utilisées).
Énoncé : Modifiez le programme rendu_monnaie de l’Exercice 2 pour qu’il renvoie non seulement le nombre minimal de pièces, mais aussi la liste exacte des pièces qui composent cette solution optimale. Vous pouvez vous inspirer de l’exemple fourni (rendu_monnaie_solution).
Exercice 4 : Suite de Fibonacci par Programmation Dynamique
Objectif : Appliquer la PD à la suite de Fibonacci en utilisant l’approche ascendante (itérative).
Énoncé : La suite de Fibonacci est définie par F0=0,F1=1 et Fn=Fn−1+Fn−2 pour n≥2. Écrivez une fonction fibonacci(n) qui calcule la valeur de Fn en utilisant la programmation dynamique (approche itérative, sans récursion).
voici un programme d’alignement de séquences fondamental sur lequel vont venir s’appuyer les exercices à suivre
def aligne(s1, s2):
    """le score du meilleur alignement de s1 et s2"""
    n1, n2 = len(s1), len(s2)
    sc = [[0] * (n2 + 1) for _ in range(n1 + 1)]
    # première ligne et première colonne
    for i in range(1, n1 + 1):
        sc[i][0] = -i
    for j in range(1, n2 + 1):
        sc[0][j] = -j
    # le reste
    for i in range(1, n1 + 1):
        for j in range(1, n2 + 1):
            s = max(-1 + sc[i - 1][j], -1 + sc[i][j - 1])
            if s1[i - 1] == s2[j - 1]:
                sc[i][j] = max(s, 1 + sc[i - 1][j - 1])
            else:
                sc[i][j] = max(s, -1 + sc[i - 1][j - 1])
    return sc[n1][n2]
Exercice 5 : Calcul du Tableau d’Alignement (Sequence Alignment)
Objectif : Appliquer manuellement la formule de récurrence du Programme 48 sur un petit exemple.
Énoncé : Le programme d’Alignement de Séquences (voir avant l’exercice 5) utilise la Programmation Dynamique pour calculer le score maximal d’alignement entre deux chaînes. Les règles de score utilisées par ce programme sont :
Match : +1
Mismatch : −1
Gap (-) : −1
Question :Calculez à la main le tableau des scores d’alignement (sc) pour les deux mots « CHAT » et « CAT ». Quel est le score maximal final ?
Exercice 6 : Alignement de Séquences Identiques (Mismatchs)
Objectif : Déterminer la structure du tableau lorsque tous les alignements sont des mismatchs ou des gaps.
Énoncé : En utilisant les règles de score du programme d’Alignement de Séquences (voir avant l’exercice 5) (+1 pour match, -1 pour mismatch/gap), quel est le score maximal d’alignement des mots s1= »AAAAAAAAAA » et s2= »BBBBBBBBBB » (10 caractères chacun) ? Décrivez la forme du tableau calculé.
Exercice 7 : Affichage Formatté de la Table de Scores
Objectif : Créer une fonction utilitaire pour visualiser le tableau de Programmation Dynamique.
Énoncé : Écrivez une fonction affiche(s1, s2, sc) qui prend les deux séquences (s1, s2) et le tableau des scores (sc) calculé par le Programme 48, et affiche la table sous un format lisible et aligné.
Exercice 8 : Alignement avec Solution (Reconstruction)
Objectif : Modifier le programme d’alignement pour reconstruire la séquence d’opérations menant au score optimal.
Énoncé : Modifiez Le programme d’Alignement de Séquences (voir avant l’exercice 5) pour qu’il renvoie également la solution optimale sous la forme d’un couple de chaînes alignées (avec le caractère - pour les gaps).
Exercice 9 : Alignement avec Matrice de Similarités et Coût de Gap
Objectif : Généraliser le Programme 48 pour utiliser une matrice de similarités personnalisée et un coût de gap variable.
Énoncé : Dans les alignements biologiques (ADN), les scores ne sont pas fixes. Nous utilisons :
Une matrice de similarités (sim) pour le score d’alignement entre deux caractères spécifiques.
Une variable globale gap pour le coût de création d’un gap (-).
Question : Indiquez comment représenter la matrice de similarités en Python et modifiez le programme d’Alignement de Séquences (voir avant l’exercice 5) pour utiliser ces variables (sim et gap).
Exercice 10 : Nombre de Chemins sur une Grille
Objectif : Résoudre un problème de dénombrement par Programmation Dynamique.
Énoncé : Écrivez une fonction chemins(n, m) qui calcule le nombre de chemins possibles sur une grille de taille n×m (partant du coin supérieur gauche 0,0 jusqu’au coin inférieur droit n,m), en se déplaçant uniquement vers la droite ou vers le bas.